 scale(0.100000,-0.100000)%22%3E%3Cpath d=%22M4297 11020 c-251 -23 -537 -106 -727 -212 -443 -246 -736 -645 -826 -1123 -18 -97 -19 -207 -19 -3245 0 -3437 -4 -3204 61 -3464 145 -585 533 -1052 1103 -1330 52 -25 105 -46 118 -46 39 0 90 26 110 56 17 27 18 80 24 959 5 900 6 934 28 1060 53 314 144 569 297 832 219 376 589 741 999 983 50 29 119 70 155 91 177 104 553 265 830 353 495 159 1130 272 1651 293 l156 6 -3 -229 c-7 -645 -130 -1193 -376 -1677 -155 -306 -373 -585 -598 -766 -329 -265 -571 -377 -1169 -542 -500 -137 -709 -225 -974 -409 -116 -80 -331 -295 -415 -415 -113 -160 -204 -370 -238 -552 -15 -79 -14 -89 1 -129 10 -28 28 -51 49 -64 33 -20 41 -20 1478 -20 1442 0 1599 3 1808 36 677 106 1325 449 1770 938 130 141 202 234 296 376 549 834 695 1868 404 2865 -103 350 -280 710 -483 980 -361 479 -868 808 -1442 935 -328 73 -460 80 -1577 80 l-908 0 0 1108 c0 1199 0 1198 -55 1387 -76 262 -240 486 -464 636 -134 90 -197 122 -340 169 -216 72 -482 102 -724 80z%22/%3E%3Cpath d=%22M6314 10340 c-26 -10 -72 -65 -79 -93 -3 -12 -4 -400 -3 -862 l3 -840 28 -79 c78 -222 264 -396 497 -467 l75 -23 867 -4 c958 -3 918 -6 958 60 11 18 20 45 20 60 0 60 79 -22 -1100 1143 -927 916 -1090 1075 -1122 1095 -34 21 -105 26 -144 10z%22/%3E%3C/g%3E%3C/g%3E%3Cpath fill=%22%230B1220%22 d=%22M1436.7552 845.272V779.8000000000001H1547.4624000000001Q1577.2224 779.8000000000001 1592.4 763.432Q1607.5776 747.0640000000001 1607.5776 717.8992000000001Q1607.5776 688.1392000000001 1591.2096000000001 670.8784Q1574.8416 653.6176 1544.4864 653.6176H1436.7552V588.1456000000001H1539.7248Q1567.6992 588.1456000000001 1582.2816 574.7536Q1596.864 561.3616 1596.864 535.1728Q1596.864 508.98400000000004 1582.8768 495.592Q1568.8896 482.2 1541.5104000000001 482.2H1436.7552V416.728H1561.152Q1618.2912000000001 416.728 1653.4080000000001 445.8928Q1688.5248000000001 475.05760000000004 1688.5248000000001 525.0544Q1688.5248000000001 556.6 1673.6448 579.2176Q1658.7648 601.8352 1633.7664 613.7392Q1608.768 625.6432 1577.8176 625.6432L1580.7936 613.144Q1614.1248 613.144 1641.2064 627.4288Q1668.288 641.7136 1684.3584 667.6048000000001Q1700.4288000000001 693.4960000000001 1700.4288000000001 728.6128Q1700.4288000000001 763.7296 1684.0608000000002 790.216Q1667.6928 816.7024 1638.2304 830.9872Q1608.768 845.272 1568.8896 845.272ZM1361.76 845.272V416.728H1453.4208V845.272Z M1742.0928 845.272V416.728H1831.3727999999999V845.272Z M2034.9312 851.224Q1984.9343999999999 851.224 1947.1391999999998 831.2848000000001Q1909.3439999999998 811.3456000000001 1888.2143999999998 775.336Q1867.0847999999999 739.3264 1867.0847999999999 692.3056Q1867.0847999999999 645.2848 1888.2143999999998 610.168Q1909.3439999999998 575.0512 1947.1391999999998 555.4096Q1984.9343999999999 535.768 2034.9312 535.768Q2085.5232 535.768 2123.3184 555.4096Q2161.1135999999997 575.0512 2181.9456 610.168Q2202.7776 645.2848 2202.7776 692.3056Q2202.7776 739.3264 2181.648 775.336Q2160.5184 811.3456000000001 2122.7232 831.2848000000001Q2084.928 851.224 2034.9312 851.224ZM2034.9312 780.9904Q2055.7632 780.9904 2072.7263999999996 770.2768000000001Q2089.6895999999997 759.5632 2099.808 739.624Q2109.9264 719.6848 2109.9264 691.7104Q2109.9264 650.6416 2088.2016 628.3216Q2066.4768 606.0016 2034.9312 606.0016Q2003.3855999999998 606.0016 1981.6607999999999 628.6192000000001Q1959.936 651.2368 1959.936 691.7104Q1959.936 719.6848 1970.0544 739.624Q1980.1727999999998 759.5632 1997.136 770.2768000000001Q2014.0991999999999 780.9904 2034.9312 780.9904Z M2378.3615999999997 973.24Q2315.2704 973.24 2275.6895999999997 946.456Q2236.1088 919.672 2228.9664 873.8416000000001H2313.4847999999997Q2318.2464 885.1504000000001 2334.0191999999997 891.1024000000001Q2349.792 897.0544000000001 2374.1952 897.0544000000001Q2414.6688 897.0544000000001 2433.12 881.5792000000001Q2451.5712 866.104 2451.5712 833.368V767.3008L2456.3328 768.4912Q2450.3808 801.8224 2421.8112 821.1664000000001Q2393.2416 840.5104 2350.9824 840.5104Q2310.5088 840.5104 2280.4512 821.7616Q2250.3936 803.0128000000001 2233.728 769.0864000000001Q2217.0624 735.1600000000001 2217.0624 689.3296Q2217.0624 642.904 2234.3232 608.3824Q2251.584 573.8608 2282.832 554.8144Q2314.08 535.768 2355.7439999999997 535.768Q2398.5984 535.768 2425.68 556.0048Q2452.7616 576.2416000000001 2457.5232 611.3584000000001L2453.3568 611.9536V541.72H2540.8512V832.1776000000001Q2540.8512 897.6496000000001 2497.4016 935.4448Q2453.9519999999998 973.24 2378.3615999999997 973.24ZM2381.9328 772.0624Q2413.4784 772.0624 2433.12 750.3376000000001Q2452.7616 728.6128 2452.7616 688.1392000000001Q2452.7616 647.6656 2432.8224 625.9408000000001Q2412.8831999999998 604.216 2380.7424 604.216Q2349.792 604.216 2329.8527999999997 626.2384Q2309.9136 648.2608 2309.9136 688.7344Q2309.9136 729.2080000000001 2329.8527999999997 750.6352Q2349.792 772.0624 2381.9328 772.0624Z%22/%3E%3Cpath fill=%22%231F63F5%22 d=%22M2718.8160000000003 845.272V486.96160000000003H2578.944V416.728H2950.3488V486.96160000000003H2810.4768V845.272Z M3131.2896 851.224Q3080.6976 851.224 3043.2 831.2848000000001Q3005.7024 811.3456000000001 2985.168 775.6336000000001Q2964.6336 739.9216 2964.6336 693.4960000000001Q2964.6336 646.4752000000001 2985.168 611.0608000000001Q3005.7024 575.6464000000001 3042.6048 555.7072000000001Q3079.5072 535.768 3128.3136 535.768Q3175.3344 535.768 3209.856 554.8144Q3244.3776000000003 573.8608 3263.424 607.7872Q3282.4704 641.7136 3282.4704 687.5440000000001Q3282.4704 697.0672000000001 3281.8752000000004 705.1024Q3281.28 713.1376 3280.0896000000002 720.28H3017.0112V661.3552H3208.0704L3192.5952 672.0688Q3192.5952 635.1664000000001 3175.0368 617.6080000000001Q3157.4784 600.0496 3127.1232 600.0496Q3092.0064 600.0496 3072.6624 623.8576Q3053.3184 647.6656 3053.3184 695.2816Q3053.3184 741.7072000000001 3072.6624 764.3248000000001Q3092.0064 786.9424 3130.6944000000003 786.9424Q3152.1216 786.9424 3167.5968000000003 779.8Q3183.072 772.6576 3190.8096 756.5872H3274.7328Q3259.8528 800.6320000000001 3223.8432000000003 825.9280000000001Q3187.8336 851.224 3131.2896 851.224Z M3318.1824 845.272V541.72H3405.6768V613.144H3407.4624000000003V845.272ZM3529.4784 845.272V657.1888Q3529.4784 632.1904000000001 3516.6816 619.6912Q3503.8848000000003 607.192 3479.4816 607.192Q3458.6496 607.192 3442.2816000000003 616.7152Q3425.9136000000003 626.2384 3416.688 642.904Q3407.4624000000003 659.5696 3407.4624000000003 682.1872000000001L3399.7248 608.9776Q3414.6048 575.6464000000001 3443.472 555.7072000000001Q3472.3392000000003 535.768 3514.5984000000003 535.768Q3565.1904000000004 535.768 3591.9744 564.04Q3618.7584 592.312 3618.7584 639.928V845.272Z M3889.5744000000004 845.272V778.0144L3895.5264 779.2048Q3889.5744000000004 811.9408000000001 3860.112 831.5824Q3830.6496 851.224 3789.5808 851.224Q3747.9168000000004 851.224 3717.264 831.8800000000001Q3686.6112000000003 812.5360000000001 3669.9456 777.4192Q3653.28 742.3024 3653.28 694.6864Q3653.28 646.4752000000001 3670.5408 610.7632000000001Q3687.8016000000002 575.0512 3719.0496000000003 555.4096Q3750.2976000000003 535.768 3791.9616000000005 535.768Q3835.4112000000005 535.768 3862.4928000000004 556.0048Q3889.5744000000004 576.2416000000001 3894.3360000000002 611.3584000000001L3887.7888000000003 611.9536V416.728H3977.0688000000005V845.272ZM3818.1504000000004 779.8000000000001Q3849.6960000000004 779.8000000000001 3869.3376000000003 757.48Q3888.9792 735.1600000000001 3888.9792 693.4960000000001Q3888.9792 651.832 3869.04 629.512Q3849.1008 607.192 3816.9600000000005 607.192Q3786.0096000000003 607.192 3766.0704000000005 629.8096Q3746.1312000000003 652.4272000000001 3746.1312000000003 694.0912000000001Q3746.1312000000003 735.7552000000001 3766.0704000000005 757.7776000000001Q3786.0096000000003 779.8000000000001 3818.1504000000004 779.8000000000001Z%22/%3E%3C/svg%3E)
 scale(0.100000,-0.100000)%22%3E%3Cpath d=%22M4297 11020 c-251 -23 -537 -106 -727 -212 -443 -246 -736 -645 -826 -1123 -18 -97 -19 -207 -19 -3245 0 -3437 -4 -3204 61 -3464 145 -585 533 -1052 1103 -1330 52 -25 105 -46 118 -46 39 0 90 26 110 56 17 27 18 80 24 959 5 900 6 934 28 1060 53 314 144 569 297 832 219 376 589 741 999 983 50 29 119 70 155 91 177 104 553 265 830 353 495 159 1130 272 1651 293 l156 6 -3 -229 c-7 -645 -130 -1193 -376 -1677 -155 -306 -373 -585 -598 -766 -329 -265 -571 -377 -1169 -542 -500 -137 -709 -225 -974 -409 -116 -80 -331 -295 -415 -415 -113 -160 -204 -370 -238 -552 -15 -79 -14 -89 1 -129 10 -28 28 -51 49 -64 33 -20 41 -20 1478 -20 1442 0 1599 3 1808 36 677 106 1325 449 1770 938 130 141 202 234 296 376 549 834 695 1868 404 2865 -103 350 -280 710 -483 980 -361 479 -868 808 -1442 935 -328 73 -460 80 -1577 80 l-908 0 0 1108 c0 1199 0 1198 -55 1387 -76 262 -240 486 -464 636 -134 90 -197 122 -340 169 -216 72 -482 102 -724 80z%22/%3E%3Cpath d=%22M6314 10340 c-26 -10 -72 -65 -79 -93 -3 -12 -4 -400 -3 -862 l3 -840 28 -79 c78 -222 264 -396 497 -467 l75 -23 867 -4 c958 -3 918 -6 958 60 11 18 20 45 20 60 0 60 79 -22 -1100 1143 -927 916 -1090 1075 -1122 1095 -34 21 -105 26 -144 10z%22/%3E%3C/g%3E%3C/g%3E%3Cpath fill=%22%23FFFFFF%22 d=%22M1436.7552 845.272V779.8000000000001H1547.4624000000001Q1577.2224 779.8000000000001 1592.4 763.432Q1607.5776 747.0640000000001 1607.5776 717.8992000000001Q1607.5776 688.1392000000001 1591.2096000000001 670.8784Q1574.8416 653.6176 1544.4864 653.6176H1436.7552V588.1456000000001H1539.7248Q1567.6992 588.1456000000001 1582.2816 574.7536Q1596.864 561.3616 1596.864 535.1728Q1596.864 508.98400000000004 1582.8768 495.592Q1568.8896 482.2 1541.5104000000001 482.2H1436.7552V416.728H1561.152Q1618.2912000000001 416.728 1653.4080000000001 445.8928Q1688.5248000000001 475.05760000000004 1688.5248000000001 525.0544Q1688.5248000000001 556.6 1673.6448 579.2176Q1658.7648 601.8352 1633.7664 613.7392Q1608.768 625.6432 1577.8176 625.6432L1580.7936 613.144Q1614.1248 613.144 1641.2064 627.4288Q1668.288 641.7136 1684.3584 667.6048000000001Q1700.4288000000001 693.4960000000001 1700.4288000000001 728.6128Q1700.4288000000001 763.7296 1684.0608000000002 790.216Q1667.6928 816.7024 1638.2304 830.9872Q1608.768 845.272 1568.8896 845.272ZM1361.76 845.272V416.728H1453.4208V845.272Z M1742.0928 845.272V416.728H1831.3727999999999V845.272Z M2034.9312 851.224Q1984.9343999999999 851.224 1947.1391999999998 831.2848000000001Q1909.3439999999998 811.3456000000001 1888.2143999999998 775.336Q1867.0847999999999 739.3264 1867.0847999999999 692.3056Q1867.0847999999999 645.2848 1888.2143999999998 610.168Q1909.3439999999998 575.0512 1947.1391999999998 555.4096Q1984.9343999999999 535.768 2034.9312 535.768Q2085.5232 535.768 2123.3184 555.4096Q2161.1135999999997 575.0512 2181.9456 610.168Q2202.7776 645.2848 2202.7776 692.3056Q2202.7776 739.3264 2181.648 775.336Q2160.5184 811.3456000000001 2122.7232 831.2848000000001Q2084.928 851.224 2034.9312 851.224ZM2034.9312 780.9904Q2055.7632 780.9904 2072.7263999999996 770.2768000000001Q2089.6895999999997 759.5632 2099.808 739.624Q2109.9264 719.6848 2109.9264 691.7104Q2109.9264 650.6416 2088.2016 628.3216Q2066.4768 606.0016 2034.9312 606.0016Q2003.3855999999998 606.0016 1981.6607999999999 628.6192000000001Q1959.936 651.2368 1959.936 691.7104Q1959.936 719.6848 1970.0544 739.624Q1980.1727999999998 759.5632 1997.136 770.2768000000001Q2014.0991999999999 780.9904 2034.9312 780.9904Z M2378.3615999999997 973.24Q2315.2704 973.24 2275.6895999999997 946.456Q2236.1088 919.672 2228.9664 873.8416000000001H2313.4847999999997Q2318.2464 885.1504000000001 2334.0191999999997 891.1024000000001Q2349.792 897.0544000000001 2374.1952 897.0544000000001Q2414.6688 897.0544000000001 2433.12 881.5792000000001Q2451.5712 866.104 2451.5712 833.368V767.3008L2456.3328 768.4912Q2450.3808 801.8224 2421.8112 821.1664000000001Q2393.2416 840.5104 2350.9824 840.5104Q2310.5088 840.5104 2280.4512 821.7616Q2250.3936 803.0128000000001 2233.728 769.0864000000001Q2217.0624 735.1600000000001 2217.0624 689.3296Q2217.0624 642.904 2234.3232 608.3824Q2251.584 573.8608 2282.832 554.8144Q2314.08 535.768 2355.7439999999997 535.768Q2398.5984 535.768 2425.68 556.0048Q2452.7616 576.2416000000001 2457.5232 611.3584000000001L2453.3568 611.9536V541.72H2540.8512V832.1776000000001Q2540.8512 897.6496000000001 2497.4016 935.4448Q2453.9519999999998 973.24 2378.3615999999997 973.24ZM2381.9328 772.0624Q2413.4784 772.0624 2433.12 750.3376000000001Q2452.7616 728.6128 2452.7616 688.1392000000001Q2452.7616 647.6656 2432.8224 625.9408000000001Q2412.8831999999998 604.216 2380.7424 604.216Q2349.792 604.216 2329.8527999999997 626.2384Q2309.9136 648.2608 2309.9136 688.7344Q2309.9136 729.2080000000001 2329.8527999999997 750.6352Q2349.792 772.0624 2381.9328 772.0624Z%22/%3E%3Cpath fill=%22%235B93FF%22 d=%22M2718.8160000000003 845.272V486.96160000000003H2578.944V416.728H2950.3488V486.96160000000003H2810.4768V845.272Z M3131.2896 851.224Q3080.6976 851.224 3043.2 831.2848000000001Q3005.7024 811.3456000000001 2985.168 775.6336000000001Q2964.6336 739.9216 2964.6336 693.4960000000001Q2964.6336 646.4752000000001 2985.168 611.0608000000001Q3005.7024 575.6464000000001 3042.6048 555.7072000000001Q3079.5072 535.768 3128.3136 535.768Q3175.3344 535.768 3209.856 554.8144Q3244.3776000000003 573.8608 3263.424 607.7872Q3282.4704 641.7136 3282.4704 687.5440000000001Q3282.4704 697.0672000000001 3281.8752000000004 705.1024Q3281.28 713.1376 3280.0896000000002 720.28H3017.0112V661.3552H3208.0704L3192.5952 672.0688Q3192.5952 635.1664000000001 3175.0368 617.6080000000001Q3157.4784 600.0496 3127.1232 600.0496Q3092.0064 600.0496 3072.6624 623.8576Q3053.3184 647.6656 3053.3184 695.2816Q3053.3184 741.7072000000001 3072.6624 764.3248000000001Q3092.0064 786.9424 3130.6944000000003 786.9424Q3152.1216 786.9424 3167.5968000000003 779.8Q3183.072 772.6576 3190.8096 756.5872H3274.7328Q3259.8528 800.6320000000001 3223.8432000000003 825.9280000000001Q3187.8336 851.224 3131.2896 851.224Z M3318.1824 845.272V541.72H3405.6768V613.144H3407.4624000000003V845.272ZM3529.4784 845.272V657.1888Q3529.4784 632.1904000000001 3516.6816 619.6912Q3503.8848000000003 607.192 3479.4816 607.192Q3458.6496 607.192 3442.2816000000003 616.7152Q3425.9136000000003 626.2384 3416.688 642.904Q3407.4624000000003 659.5696 3407.4624000000003 682.1872000000001L3399.7248 608.9776Q3414.6048 575.6464000000001 3443.472 555.7072000000001Q3472.3392000000003 535.768 3514.5984000000003 535.768Q3565.1904000000004 535.768 3591.9744 564.04Q3618.7584 592.312 3618.7584 639.928V845.272Z M3889.5744000000004 845.272V778.0144L3895.5264 779.2048Q3889.5744000000004 811.9408000000001 3860.112 831.5824Q3830.6496 851.224 3789.5808 851.224Q3747.9168000000004 851.224 3717.264 831.8800000000001Q3686.6112000000003 812.5360000000001 3669.9456 777.4192Q3653.28 742.3024 3653.28 694.6864Q3653.28 646.4752000000001 3670.5408 610.7632000000001Q3687.8016000000002 575.0512 3719.0496000000003 555.4096Q3750.2976000000003 535.768 3791.9616000000005 535.768Q3835.4112000000005 535.768 3862.4928000000004 556.0048Q3889.5744000000004 576.2416000000001 3894.3360000000002 611.3584000000001L3887.7888000000003 611.9536V416.728H3977.0688000000005V845.272ZM3818.1504000000004 779.8000000000001Q3849.6960000000004 779.8000000000001 3869.3376000000003 757.48Q3888.9792 735.1600000000001 3888.9792 693.4960000000001Q3888.9792 651.832 3869.04 629.512Q3849.1008 607.192 3816.9600000000005 607.192Q3786.0096000000003 607.192 3766.0704000000005 629.8096Q3746.1312000000003 652.4272000000001 3746.1312000000003 694.0912000000001Q3746.1312000000003 735.7552000000001 3766.0704000000005 757.7776000000001Q3786.0096000000003 779.8000000000001 3818.1504000000004 779.8000000000001Z%22/%3E%3C/svg%3E)
Come la ricerca web in tempo reale garantisce l'accuratezza dei contenuti nel blogging automatizzato
I sistemi di blogging automatizzati che utilizzano la ricerca web in tempo reale riducono i tassi di allucinazione del 73-86% tramite il recupero di dati in tempo reale. Questo articolo spiega come funziona la generazione aumentata dal recupero (RAG) e perché è importante per la SEO.
I sistemi di blogging automatizzati che si affidano esclusivamente a grandi modelli linguistici pre-addestrati producono spesso errori fattuali e affermazioni obsolete. La ricerca web live per il blogging automatizzato, basata su architetture di generazione aumentata dal recupero (RAG), riduce i tassi di allucinazione del 73-86% integrando dati in tempo reale nel processo di generazione, anziché dipendere da pesi di addestramento statici.
Perché i contenuti standard automatizzati falliscono sui fatti
I grandi modelli linguistici generano testo prevedendo i token successivi più probabili in base ai pattern di addestramento. Questo crea prosa fluente ma non garantisce l'accuratezza. Quando un modello non dispone di conoscenza parametrica affidabile per una specifica affermazione, va in allucinazione. Fabbrica fatti, citazioni, date o statistiche che suonano plausibili ma sono false.
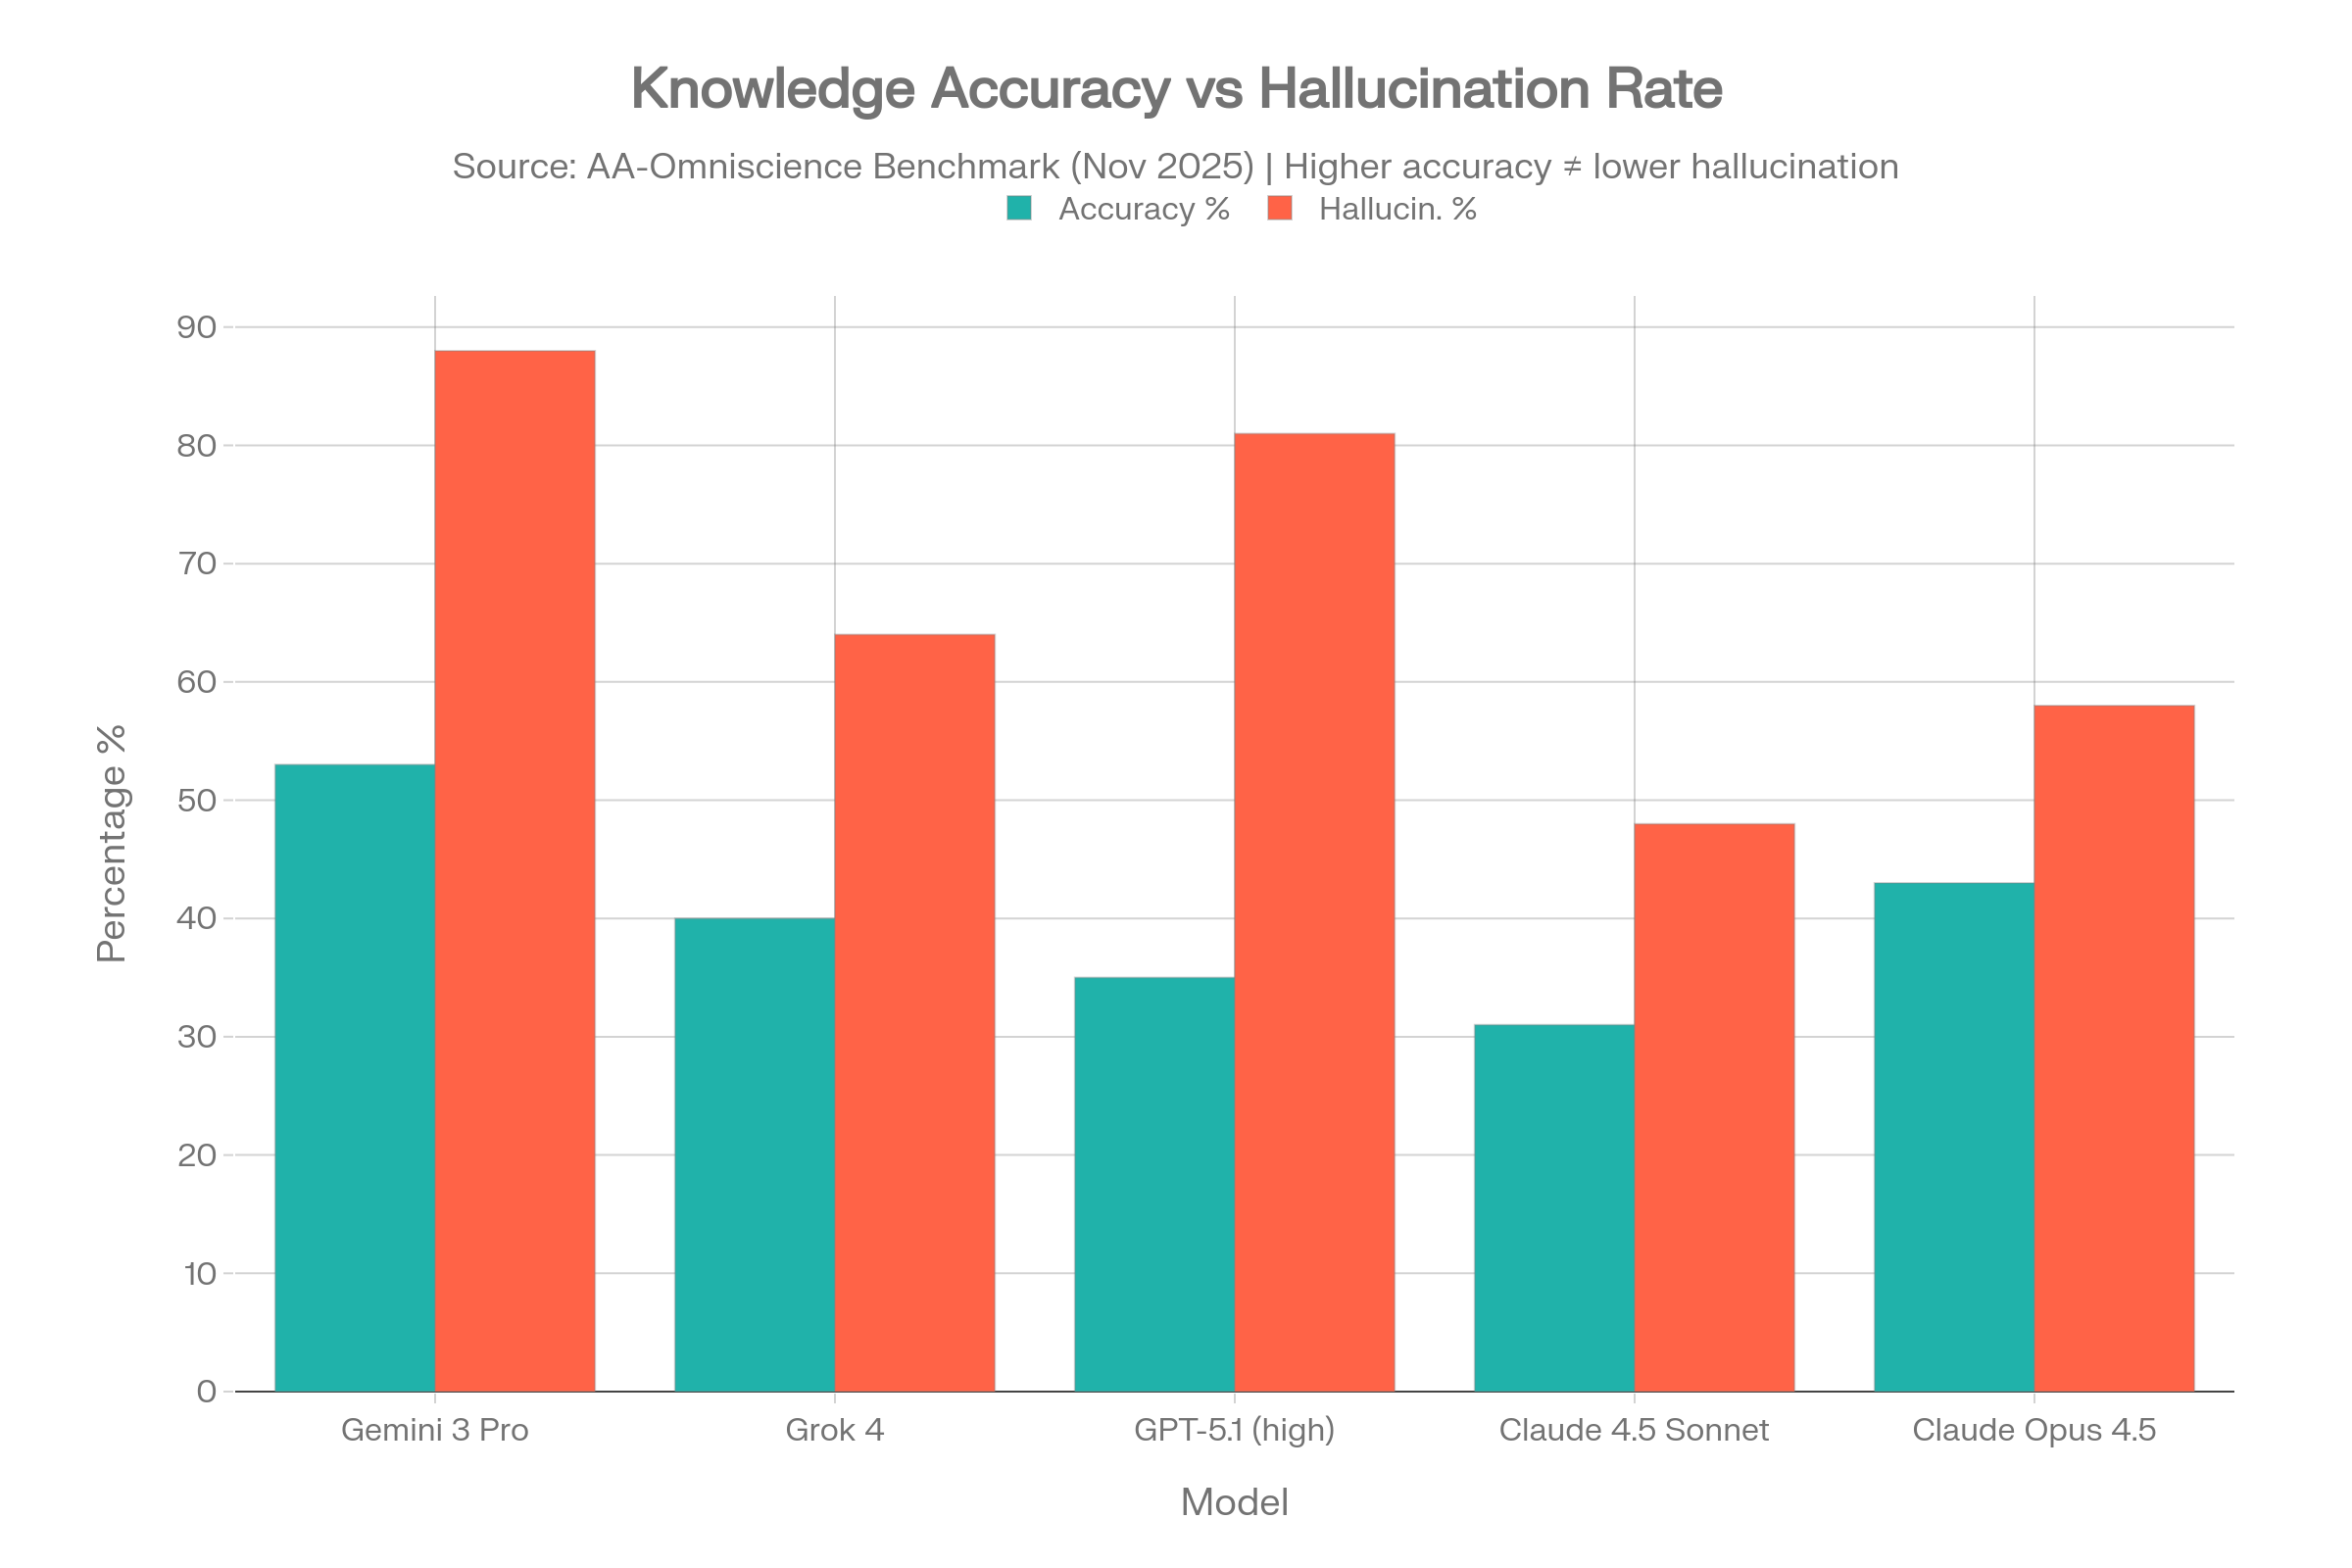
Su benchmark open-domain come FActScore e SimpleQA, gli LLM non ancorati alla realtà vanno in allucinazione con tassi tra il 37% e il 47% nei task di lungo periodo, secondo l'analisi dell'accuratezza 2026 di Suprmind. Il problema peggiora nelle nicchie in rapida evoluzione dove i dati di addestramento non riescono a catturare gli sviluppi recenti.
I modelli statici falliscono regolarmente su:
- Prezzi attuali, tassi di cambio e dati di mercato
- Normative recentemente approvate o cambiamenti politici
- Notizie dell'ultima ora e tendenze emergenti
- Specifiche e disponibilità dei prodotti
- Statistiche aggiornate da ricerche in corso
Senza il recupero di dati live, un post blog automatizzato sulle "soglie di dichiarazione dei redditi 2026" propagherà probabilmente informazioni obsolete. I lettori se ne accorgono, la fiducia erode e i motori di ricerca penalizzano i contenuti scarsi.
Cosa significa la ricerca web live per il blogging automatizzato
La ricerca web live nell'automazione è la pratica di interrogare motori di ricerca, API e database strutturati durante la generazione dei contenuti. Il sistema inietta poi le informazioni recuperate nella finestra di contesto del modello. Questo si basa sul recupero in tempo reale piuttosto che sulla pre-elaborazione di una base di conoscenza statica.
La tecnica è chiamata Generazione Aumentata dal Recupero (RAG). Formalizzata per la prima volta nella ricerca di Lewis et al. del 2020 sui task NLP knowledge-intensive, la RAG separa la capacità di ragionamento del modello linguistico dalla sua base di conoscenza fattuale. Il modello scrive; il sistema di recupero fornisce i fatti.
Gli stack moderni di blogging automatizzato utilizzano due distinti livelli di recupero:
| Tipo di livello | Esempi | Formato di output | Più adatto per |
|---|---|---|---|
| Recupero web AI-native | Tavily, Exa, Linkup, Brave Search API | Markdown pre-pulito, riassunti semantici | Iniezione diretta nel contesto LLM |
| Scraper SERP tradizionali | SerpApi, Serper.dev, Firecrawl | Metadati SERP grezzi, richiedono parsing HTML | Pipeline di estrazione personalizzate |
Microsoft ha ritirato l'API Bing Search standalone l'11 agosto 2025, accelerando la migrazione verso alternative AI-native. La Brave Search API indicizza oltre 40 miliardi di pagine indipendentemente da Google o Bing, offrendo un corpus distinto per la verifica.
La pipeline di ricerca live: dalla query al fatto pubblicato
Una pipeline RAG di produzione per il blogging automatizzato segue cinque fasi sequenziali. Ogni fase aggiunge latenza ma migliora la qualità dell'output.
- Formulazione della queryIl sistema analizza il brief dell'articolo e converte le affermazioni in specifiche query di ricerca. "Discutere le aliquote delle plusvalenze 2026" diventa query mirate per pubblicazioni IRS e giornalismo finanziario verificato.
- Recupero delle fontiLe API di ricerca restituiscono risultati classificati. Le pipeline avanzate eseguono multiple query parallele e applicano il reranking cross-encoder per far emergere i passaggi più rilevanti.
- Iniezione del contestoIl testo recuperato viene frammentato, deduplicato e formattato per la finestra di contesto dell'LLM. Le API AI-native come Tavily restituiscono markdown pre-strutturato ottimizzato per questo passaggio.
- Generazione ancorataIl modello genera prosa vincolata dal contesto iniettato. Può citare, parafrasare o sintetizzare, ma le sue affermazioni fattuali sono legate alle fonti recuperate piuttosto che alla memoria parametrica.
- Verifica e scoringL'output passa attraverso il fact-checking automatizzato utilizzando framework come la Triade RAG (Fedeltà, Pertinenza della Risposta, Precisione del Contesto) e la verifica delle proposizioni atomiche FActScore. Il cross-encoder HHEM di Vectara segnala contraddizioni fattuali prima della pubblicazione.
Questa latenza è proibitiva per i chatbot interattivi ma gestibile per il blogging automatizzato. Le pipeline di produzione disaccoppiano la generazione dalle richieste degli utenti utilizzando code di lavoro asincrone come Celery o BullMQ. Gli articoli vengono generati in background e pubblicati secondo programma.
Attribuzione delle fonti e segnali di fiducia
I contenuti basati su ricerche live includono citazioni inline alle fonti primarie. Questo permette ai lettori di verificare le affermazioni e segnala ai motori di ricerca che il contenuto è supportato da prove.
L'autorità del dominio è fondamentale nella selezione delle fonti. Una pipeline che recupera dati da domini .gov, testate giornalistiche consolidate e riviste peer-reviewed produce output più affidabili rispetto a una che effettua scraping di forum non moderati. I sistemi di produzione filtrano in base alla reputazione del dominio ed escludono le fonti conosciute per la bassa credibilità.
La differenza tra output statico e output basato su ricerche live è netta:
| Dimensione | Output LLM statico | Output RAG basato su ricerche live |
|---|---|---|
| Freschezza dei fatti | Congelata al momento dell'addestramento | Aggiornata al momento della generazione |
| Tasso di allucinazione (FActScore) | 37–47% | Sotto il 10% |
| Verificabilità delle fonti | Nessuna | Citazioni inline alle pagine recuperate |
| Profilo di rischio SEO | Alto: non originale, potenzialmente falso | Più basso: supportato da prove, fresco |
| Segnali di fiducia per il lettore | Affermazioni generiche, senza riferimenti | Fatti specifici, attribuiti |
Prestazioni SEO e la posizione di Google sui contenuti automatizzati
Google non vieta i contenuti generati dall'IA. Vieta i contenuti di bassa qualità e manipolativi indipendentemente dal metodo di produzione. La guida ufficiale di Google afferma: "Premiare contenuti di qualità, indipendentemente da come sono prodotti, è stato un elemento centrale della Ricerca per molti anni."
Tuttavia, l'aggiornamento core di marzo 2024 ha alzato la posta in gioco. L'azienda ha ritirato il suo classificatore autonomo Helpful Content System e ha assorbito i segnali di utilità negli algoritmi di ranking principali. Ha introdotto la policy anti-spam "Scaled Content Abuse", definita come la generazione di molte pagine principalmente per manipolare le classifiche di ricerca senza aggiungere valore per gli utenti.
Lo scaled content abuse si verifica quando vengono generate molte pagine con lo scopo principale di manipolare le classifiche di ricerca e non di aiutare gli utenti. Questa pratica abusiva è tipicamente focalizzata sulla creazione di grandi quantità di contenuti non originali che offrono poco o nessun valore agli utenti, indipendentemente da come siano creati.
Documentazione di Google Search Central, Policy ufficiali anti-spam per la Web Search
L'aggiornamento di marzo 2024 ha portato risultati misurabili: Google ha confermato una riduzione del 45% dei contenuti di bassa qualità e non originali presenti nei risultati di ricerca dopo il completamento del rollout.
La ricerca web live affronta direttamente i segnali di qualità di Google. Contenuti freschi e attribuiti dimostrano Esperienza, Competenza, Autorevolezza e Affidabilità (E-E-A-T). Le risposte accurate riducono la frequenza di rimbalzo perché i lettori trovano ciò che cercavano invece di imbattersi in informazioni obsolete.
Insidie nell'implementazione e come gestirle
La ricerca live non equivale automaticamente a qualità. Un'implementazione scarsa introduce nuove modalità di fallimento.
Contenuti a pagamento e limitati
I sistemi di recupero incontrano frequentemente articoli di notizie a pagamento o paper di ricerca ad accesso limitato. Il titolo può essere recuperato, ma il contesto fattuale completo è inaccessibile. Le pipeline di produzione dovrebbero rilevare gli indicatori di paywall ed escludere queste fonti o segnalarle per una revisione umana piuttosto che sintetizzare da informazioni incomplete.
Fonti in conflitto
La ricerca live può restituire affermazioni contraddittorie provenienti da fonti ugualmente credibili. Le pipeline robuste evidenziano questi conflitti anziché selezionare arbitrariamente una versione. L'articolo generato dovrebbe riconoscere l'incertezza o presentare molteplici prospettive verificate.
Contaminazione da scraper di bassa qualità
I risultati di ricerca includono content farm e riassunti auto-generati privi di reportage originale. Senza filtri, una pipeline RAG può inglobare e rigurgitare questo materiale. Liste bianche di domini, ponderazione della freschezza dei contenuti e deduplicazione semantica aiutano a escludere il rumore.
Confini del copyright e fair use
Lo scraping live solleva considerazioni legali. I sistemi di recupero scaricano e memorizzano temporaneamente contenuti web protetti da copyright per l'analisi. Il fair use generalmente protegge la copia intermedia per scopi trasformativi come la sintesi, ma la riproduzione integrale viola il copyright. Le pipeline di blogging automatizzato dovrebbero:
- Limitare le citazioni dirette a brevi estratti attribuiti
- Trasformare le informazioni recuperate attraverso una sintesi e una struttura originali
- Inserire link alle fonti invece di sostituirle
- Rispettare i file robots.txt e i termini di servizio dei siti di destinazione
Il valore aggiunto dalla ricerca live risiede nella verifica e nell'aggiornamento. I sistemi che si limitano a ripubblicare testo estratto tramite scraping senza alcuna elaborazione violano sia le politiche anti-spam di Google sia la normativa sul diritto d'autore.
Valutare se il proprio setup necessita di ricerca live
Non tutti gli articoli del blog richiedono un recupero in tempo reale. I contenuti evergreen su argomenti consolidati possono essere adeguatamente serviti da basi di conoscenza statiche ben curate. Tuttavia, la ricerca live diventa essenziale quando i contenuti coprono:
- Notizie sensibili al tempo e analisi delle tendenze
- Dati finanziari, prezzi e condizioni di mercato
- Conformità normativa e requisiti legali
- Recensioni di prodotti e specifiche tecniche
- Intelligence competitiva e benchmark di settore
- Copertura di eventi e annunci programmati
Se il tuo blog automatizzato opera in questi ambiti e attualmente genera contenuti senza fondamento live, il tasso di errori fattuali si avvicina probabilmente alla baseline del 37–47% documentata nella ricerca sulle allucinazioni degli LLM. Il miglioramento dal 73% all'86% derivante dall'integrazione RAG rappresenta un upgrade diretto della qualità che lettori e motori di ricerca noteranno.
Cosa controllare prima che il prossimo post automatico vada online
- Ogni statistica, data e nome proprio è riconducibile a una fonte recuperata con un URL funzionante?
- Le fonti provengono da domini credibili anziché da forum non verificati o content farm?
- L'articolo aggiunge struttura originale e sintesi, oppure si limita a riorganizzare frasi estratte tramite scraping?
- Hai verificato che non siano state citate fonti a pagamento senza prove accessibili?
- Le informazioni sono aggiornate al momento della generazione, o potrebbe essersi insinuata la vetustà dovuta al cutoff dell'addestramento?
La pubblicazione automatica su larga scala richiede più della semplice generazione di testi fluidi. Richiede uno strato di verifica che colleghi ogni affermazione al web live. Se stai valutando piattaforme, confronta i piani che includono infrastruttura di ricerca live rispetto a quelli che si affidano esclusivamente all'output statico del modello. Per i team pronti all'implementazione, inizia con un sistema che fondi la generazione sui dati in tempo reale fin dal primo articolo.
Continua a leggere
Altri articoli su Automazione del blog
- Blog AutomationOct 4, 2026
Web Integration for Blog Automation: How to Choose the Right Tools
Web integration for blog automation connects content generation pipelines to CMS platforms through APIs and middleware, eliminating manual copy-pasting and enabling scalable publishing workflows.
Leggi l'articolo - Flussi di lavoro di pubblicazioneOct 4, 2026
Come implementare l'automazione dei contenuti basata su ricerche web in tempo reale per le pipeline di scrittura AI
Scopri come creare una pipeline di ricerca web in tempo reale che collega API di ricerca live a sistemi di scrittura LLM, con passaggi specifici per l'estrazione dei dati, il grounding delle fonti, l'attribuzione automatica e la validazione pre-pubblicazione.
Leggi l'articolo - WordPressOct 4, 2026
Pipeline di contenuti automatizzati per WordPress: integrazione e flusso di lavoro
La creazione automatica dei contenuti in WordPress utilizza l'API REST per pubblicare articoli ottimizzati e basati su ricerche AI direttamente sul tuo sito. Questo trasforma il blogger da scrittore a stratega editoriale, responsabile della supervisione di prompt, fatti e criteri di qualità.
Leggi l'articolo