 scale(0.100000,-0.100000)%22%3E%3Cpath d=%22M4297 11020 c-251 -23 -537 -106 -727 -212 -443 -246 -736 -645 -826 -1123 -18 -97 -19 -207 -19 -3245 0 -3437 -4 -3204 61 -3464 145 -585 533 -1052 1103 -1330 52 -25 105 -46 118 -46 39 0 90 26 110 56 17 27 18 80 24 959 5 900 6 934 28 1060 53 314 144 569 297 832 219 376 589 741 999 983 50 29 119 70 155 91 177 104 553 265 830 353 495 159 1130 272 1651 293 l156 6 -3 -229 c-7 -645 -130 -1193 -376 -1677 -155 -306 -373 -585 -598 -766 -329 -265 -571 -377 -1169 -542 -500 -137 -709 -225 -974 -409 -116 -80 -331 -295 -415 -415 -113 -160 -204 -370 -238 -552 -15 -79 -14 -89 1 -129 10 -28 28 -51 49 -64 33 -20 41 -20 1478 -20 1442 0 1599 3 1808 36 677 106 1325 449 1770 938 130 141 202 234 296 376 549 834 695 1868 404 2865 -103 350 -280 710 -483 980 -361 479 -868 808 -1442 935 -328 73 -460 80 -1577 80 l-908 0 0 1108 c0 1199 0 1198 -55 1387 -76 262 -240 486 -464 636 -134 90 -197 122 -340 169 -216 72 -482 102 -724 80z%22/%3E%3Cpath d=%22M6314 10340 c-26 -10 -72 -65 -79 -93 -3 -12 -4 -400 -3 -862 l3 -840 28 -79 c78 -222 264 -396 497 -467 l75 -23 867 -4 c958 -3 918 -6 958 60 11 18 20 45 20 60 0 60 79 -22 -1100 1143 -927 916 -1090 1075 -1122 1095 -34 21 -105 26 -144 10z%22/%3E%3C/g%3E%3C/g%3E%3Cpath fill=%22%230B1220%22 d=%22M1436.7552 845.272V779.8000000000001H1547.4624000000001Q1577.2224 779.8000000000001 1592.4 763.432Q1607.5776 747.0640000000001 1607.5776 717.8992000000001Q1607.5776 688.1392000000001 1591.2096000000001 670.8784Q1574.8416 653.6176 1544.4864 653.6176H1436.7552V588.1456000000001H1539.7248Q1567.6992 588.1456000000001 1582.2816 574.7536Q1596.864 561.3616 1596.864 535.1728Q1596.864 508.98400000000004 1582.8768 495.592Q1568.8896 482.2 1541.5104000000001 482.2H1436.7552V416.728H1561.152Q1618.2912000000001 416.728 1653.4080000000001 445.8928Q1688.5248000000001 475.05760000000004 1688.5248000000001 525.0544Q1688.5248000000001 556.6 1673.6448 579.2176Q1658.7648 601.8352 1633.7664 613.7392Q1608.768 625.6432 1577.8176 625.6432L1580.7936 613.144Q1614.1248 613.144 1641.2064 627.4288Q1668.288 641.7136 1684.3584 667.6048000000001Q1700.4288000000001 693.4960000000001 1700.4288000000001 728.6128Q1700.4288000000001 763.7296 1684.0608000000002 790.216Q1667.6928 816.7024 1638.2304 830.9872Q1608.768 845.272 1568.8896 845.272ZM1361.76 845.272V416.728H1453.4208V845.272Z M1742.0928 845.272V416.728H1831.3727999999999V845.272Z M2034.9312 851.224Q1984.9343999999999 851.224 1947.1391999999998 831.2848000000001Q1909.3439999999998 811.3456000000001 1888.2143999999998 775.336Q1867.0847999999999 739.3264 1867.0847999999999 692.3056Q1867.0847999999999 645.2848 1888.2143999999998 610.168Q1909.3439999999998 575.0512 1947.1391999999998 555.4096Q1984.9343999999999 535.768 2034.9312 535.768Q2085.5232 535.768 2123.3184 555.4096Q2161.1135999999997 575.0512 2181.9456 610.168Q2202.7776 645.2848 2202.7776 692.3056Q2202.7776 739.3264 2181.648 775.336Q2160.5184 811.3456000000001 2122.7232 831.2848000000001Q2084.928 851.224 2034.9312 851.224ZM2034.9312 780.9904Q2055.7632 780.9904 2072.7263999999996 770.2768000000001Q2089.6895999999997 759.5632 2099.808 739.624Q2109.9264 719.6848 2109.9264 691.7104Q2109.9264 650.6416 2088.2016 628.3216Q2066.4768 606.0016 2034.9312 606.0016Q2003.3855999999998 606.0016 1981.6607999999999 628.6192000000001Q1959.936 651.2368 1959.936 691.7104Q1959.936 719.6848 1970.0544 739.624Q1980.1727999999998 759.5632 1997.136 770.2768000000001Q2014.0991999999999 780.9904 2034.9312 780.9904Z M2378.3615999999997 973.24Q2315.2704 973.24 2275.6895999999997 946.456Q2236.1088 919.672 2228.9664 873.8416000000001H2313.4847999999997Q2318.2464 885.1504000000001 2334.0191999999997 891.1024000000001Q2349.792 897.0544000000001 2374.1952 897.0544000000001Q2414.6688 897.0544000000001 2433.12 881.5792000000001Q2451.5712 866.104 2451.5712 833.368V767.3008L2456.3328 768.4912Q2450.3808 801.8224 2421.8112 821.1664000000001Q2393.2416 840.5104 2350.9824 840.5104Q2310.5088 840.5104 2280.4512 821.7616Q2250.3936 803.0128000000001 2233.728 769.0864000000001Q2217.0624 735.1600000000001 2217.0624 689.3296Q2217.0624 642.904 2234.3232 608.3824Q2251.584 573.8608 2282.832 554.8144Q2314.08 535.768 2355.7439999999997 535.768Q2398.5984 535.768 2425.68 556.0048Q2452.7616 576.2416000000001 2457.5232 611.3584000000001L2453.3568 611.9536V541.72H2540.8512V832.1776000000001Q2540.8512 897.6496000000001 2497.4016 935.4448Q2453.9519999999998 973.24 2378.3615999999997 973.24ZM2381.9328 772.0624Q2413.4784 772.0624 2433.12 750.3376000000001Q2452.7616 728.6128 2452.7616 688.1392000000001Q2452.7616 647.6656 2432.8224 625.9408000000001Q2412.8831999999998 604.216 2380.7424 604.216Q2349.792 604.216 2329.8527999999997 626.2384Q2309.9136 648.2608 2309.9136 688.7344Q2309.9136 729.2080000000001 2329.8527999999997 750.6352Q2349.792 772.0624 2381.9328 772.0624Z%22/%3E%3Cpath fill=%22%231F63F5%22 d=%22M2718.8160000000003 845.272V486.96160000000003H2578.944V416.728H2950.3488V486.96160000000003H2810.4768V845.272Z M3131.2896 851.224Q3080.6976 851.224 3043.2 831.2848000000001Q3005.7024 811.3456000000001 2985.168 775.6336000000001Q2964.6336 739.9216 2964.6336 693.4960000000001Q2964.6336 646.4752000000001 2985.168 611.0608000000001Q3005.7024 575.6464000000001 3042.6048 555.7072000000001Q3079.5072 535.768 3128.3136 535.768Q3175.3344 535.768 3209.856 554.8144Q3244.3776000000003 573.8608 3263.424 607.7872Q3282.4704 641.7136 3282.4704 687.5440000000001Q3282.4704 697.0672000000001 3281.8752000000004 705.1024Q3281.28 713.1376 3280.0896000000002 720.28H3017.0112V661.3552H3208.0704L3192.5952 672.0688Q3192.5952 635.1664000000001 3175.0368 617.6080000000001Q3157.4784 600.0496 3127.1232 600.0496Q3092.0064 600.0496 3072.6624 623.8576Q3053.3184 647.6656 3053.3184 695.2816Q3053.3184 741.7072000000001 3072.6624 764.3248000000001Q3092.0064 786.9424 3130.6944000000003 786.9424Q3152.1216 786.9424 3167.5968000000003 779.8Q3183.072 772.6576 3190.8096 756.5872H3274.7328Q3259.8528 800.6320000000001 3223.8432000000003 825.9280000000001Q3187.8336 851.224 3131.2896 851.224Z M3318.1824 845.272V541.72H3405.6768V613.144H3407.4624000000003V845.272ZM3529.4784 845.272V657.1888Q3529.4784 632.1904000000001 3516.6816 619.6912Q3503.8848000000003 607.192 3479.4816 607.192Q3458.6496 607.192 3442.2816000000003 616.7152Q3425.9136000000003 626.2384 3416.688 642.904Q3407.4624000000003 659.5696 3407.4624000000003 682.1872000000001L3399.7248 608.9776Q3414.6048 575.6464000000001 3443.472 555.7072000000001Q3472.3392000000003 535.768 3514.5984000000003 535.768Q3565.1904000000004 535.768 3591.9744 564.04Q3618.7584 592.312 3618.7584 639.928V845.272Z M3889.5744000000004 845.272V778.0144L3895.5264 779.2048Q3889.5744000000004 811.9408000000001 3860.112 831.5824Q3830.6496 851.224 3789.5808 851.224Q3747.9168000000004 851.224 3717.264 831.8800000000001Q3686.6112000000003 812.5360000000001 3669.9456 777.4192Q3653.28 742.3024 3653.28 694.6864Q3653.28 646.4752000000001 3670.5408 610.7632000000001Q3687.8016000000002 575.0512 3719.0496000000003 555.4096Q3750.2976000000003 535.768 3791.9616000000005 535.768Q3835.4112000000005 535.768 3862.4928000000004 556.0048Q3889.5744000000004 576.2416000000001 3894.3360000000002 611.3584000000001L3887.7888000000003 611.9536V416.728H3977.0688000000005V845.272ZM3818.1504000000004 779.8000000000001Q3849.6960000000004 779.8000000000001 3869.3376000000003 757.48Q3888.9792 735.1600000000001 3888.9792 693.4960000000001Q3888.9792 651.832 3869.04 629.512Q3849.1008 607.192 3816.9600000000005 607.192Q3786.0096000000003 607.192 3766.0704000000005 629.8096Q3746.1312000000003 652.4272000000001 3746.1312000000003 694.0912000000001Q3746.1312000000003 735.7552000000001 3766.0704000000005 757.7776000000001Q3786.0096000000003 779.8000000000001 3818.1504000000004 779.8000000000001Z%22/%3E%3C/svg%3E)
 scale(0.100000,-0.100000)%22%3E%3Cpath d=%22M4297 11020 c-251 -23 -537 -106 -727 -212 -443 -246 -736 -645 -826 -1123 -18 -97 -19 -207 -19 -3245 0 -3437 -4 -3204 61 -3464 145 -585 533 -1052 1103 -1330 52 -25 105 -46 118 -46 39 0 90 26 110 56 17 27 18 80 24 959 5 900 6 934 28 1060 53 314 144 569 297 832 219 376 589 741 999 983 50 29 119 70 155 91 177 104 553 265 830 353 495 159 1130 272 1651 293 l156 6 -3 -229 c-7 -645 -130 -1193 -376 -1677 -155 -306 -373 -585 -598 -766 -329 -265 -571 -377 -1169 -542 -500 -137 -709 -225 -974 -409 -116 -80 -331 -295 -415 -415 -113 -160 -204 -370 -238 -552 -15 -79 -14 -89 1 -129 10 -28 28 -51 49 -64 33 -20 41 -20 1478 -20 1442 0 1599 3 1808 36 677 106 1325 449 1770 938 130 141 202 234 296 376 549 834 695 1868 404 2865 -103 350 -280 710 -483 980 -361 479 -868 808 -1442 935 -328 73 -460 80 -1577 80 l-908 0 0 1108 c0 1199 0 1198 -55 1387 -76 262 -240 486 -464 636 -134 90 -197 122 -340 169 -216 72 -482 102 -724 80z%22/%3E%3Cpath d=%22M6314 10340 c-26 -10 -72 -65 -79 -93 -3 -12 -4 -400 -3 -862 l3 -840 28 -79 c78 -222 264 -396 497 -467 l75 -23 867 -4 c958 -3 918 -6 958 60 11 18 20 45 20 60 0 60 79 -22 -1100 1143 -927 916 -1090 1075 -1122 1095 -34 21 -105 26 -144 10z%22/%3E%3C/g%3E%3C/g%3E%3Cpath fill=%22%23FFFFFF%22 d=%22M1436.7552 845.272V779.8000000000001H1547.4624000000001Q1577.2224 779.8000000000001 1592.4 763.432Q1607.5776 747.0640000000001 1607.5776 717.8992000000001Q1607.5776 688.1392000000001 1591.2096000000001 670.8784Q1574.8416 653.6176 1544.4864 653.6176H1436.7552V588.1456000000001H1539.7248Q1567.6992 588.1456000000001 1582.2816 574.7536Q1596.864 561.3616 1596.864 535.1728Q1596.864 508.98400000000004 1582.8768 495.592Q1568.8896 482.2 1541.5104000000001 482.2H1436.7552V416.728H1561.152Q1618.2912000000001 416.728 1653.4080000000001 445.8928Q1688.5248000000001 475.05760000000004 1688.5248000000001 525.0544Q1688.5248000000001 556.6 1673.6448 579.2176Q1658.7648 601.8352 1633.7664 613.7392Q1608.768 625.6432 1577.8176 625.6432L1580.7936 613.144Q1614.1248 613.144 1641.2064 627.4288Q1668.288 641.7136 1684.3584 667.6048000000001Q1700.4288000000001 693.4960000000001 1700.4288000000001 728.6128Q1700.4288000000001 763.7296 1684.0608000000002 790.216Q1667.6928 816.7024 1638.2304 830.9872Q1608.768 845.272 1568.8896 845.272ZM1361.76 845.272V416.728H1453.4208V845.272Z M1742.0928 845.272V416.728H1831.3727999999999V845.272Z M2034.9312 851.224Q1984.9343999999999 851.224 1947.1391999999998 831.2848000000001Q1909.3439999999998 811.3456000000001 1888.2143999999998 775.336Q1867.0847999999999 739.3264 1867.0847999999999 692.3056Q1867.0847999999999 645.2848 1888.2143999999998 610.168Q1909.3439999999998 575.0512 1947.1391999999998 555.4096Q1984.9343999999999 535.768 2034.9312 535.768Q2085.5232 535.768 2123.3184 555.4096Q2161.1135999999997 575.0512 2181.9456 610.168Q2202.7776 645.2848 2202.7776 692.3056Q2202.7776 739.3264 2181.648 775.336Q2160.5184 811.3456000000001 2122.7232 831.2848000000001Q2084.928 851.224 2034.9312 851.224ZM2034.9312 780.9904Q2055.7632 780.9904 2072.7263999999996 770.2768000000001Q2089.6895999999997 759.5632 2099.808 739.624Q2109.9264 719.6848 2109.9264 691.7104Q2109.9264 650.6416 2088.2016 628.3216Q2066.4768 606.0016 2034.9312 606.0016Q2003.3855999999998 606.0016 1981.6607999999999 628.6192000000001Q1959.936 651.2368 1959.936 691.7104Q1959.936 719.6848 1970.0544 739.624Q1980.1727999999998 759.5632 1997.136 770.2768000000001Q2014.0991999999999 780.9904 2034.9312 780.9904Z M2378.3615999999997 973.24Q2315.2704 973.24 2275.6895999999997 946.456Q2236.1088 919.672 2228.9664 873.8416000000001H2313.4847999999997Q2318.2464 885.1504000000001 2334.0191999999997 891.1024000000001Q2349.792 897.0544000000001 2374.1952 897.0544000000001Q2414.6688 897.0544000000001 2433.12 881.5792000000001Q2451.5712 866.104 2451.5712 833.368V767.3008L2456.3328 768.4912Q2450.3808 801.8224 2421.8112 821.1664000000001Q2393.2416 840.5104 2350.9824 840.5104Q2310.5088 840.5104 2280.4512 821.7616Q2250.3936 803.0128000000001 2233.728 769.0864000000001Q2217.0624 735.1600000000001 2217.0624 689.3296Q2217.0624 642.904 2234.3232 608.3824Q2251.584 573.8608 2282.832 554.8144Q2314.08 535.768 2355.7439999999997 535.768Q2398.5984 535.768 2425.68 556.0048Q2452.7616 576.2416000000001 2457.5232 611.3584000000001L2453.3568 611.9536V541.72H2540.8512V832.1776000000001Q2540.8512 897.6496000000001 2497.4016 935.4448Q2453.9519999999998 973.24 2378.3615999999997 973.24ZM2381.9328 772.0624Q2413.4784 772.0624 2433.12 750.3376000000001Q2452.7616 728.6128 2452.7616 688.1392000000001Q2452.7616 647.6656 2432.8224 625.9408000000001Q2412.8831999999998 604.216 2380.7424 604.216Q2349.792 604.216 2329.8527999999997 626.2384Q2309.9136 648.2608 2309.9136 688.7344Q2309.9136 729.2080000000001 2329.8527999999997 750.6352Q2349.792 772.0624 2381.9328 772.0624Z%22/%3E%3Cpath fill=%22%235B93FF%22 d=%22M2718.8160000000003 845.272V486.96160000000003H2578.944V416.728H2950.3488V486.96160000000003H2810.4768V845.272Z M3131.2896 851.224Q3080.6976 851.224 3043.2 831.2848000000001Q3005.7024 811.3456000000001 2985.168 775.6336000000001Q2964.6336 739.9216 2964.6336 693.4960000000001Q2964.6336 646.4752000000001 2985.168 611.0608000000001Q3005.7024 575.6464000000001 3042.6048 555.7072000000001Q3079.5072 535.768 3128.3136 535.768Q3175.3344 535.768 3209.856 554.8144Q3244.3776000000003 573.8608 3263.424 607.7872Q3282.4704 641.7136 3282.4704 687.5440000000001Q3282.4704 697.0672000000001 3281.8752000000004 705.1024Q3281.28 713.1376 3280.0896000000002 720.28H3017.0112V661.3552H3208.0704L3192.5952 672.0688Q3192.5952 635.1664000000001 3175.0368 617.6080000000001Q3157.4784 600.0496 3127.1232 600.0496Q3092.0064 600.0496 3072.6624 623.8576Q3053.3184 647.6656 3053.3184 695.2816Q3053.3184 741.7072000000001 3072.6624 764.3248000000001Q3092.0064 786.9424 3130.6944000000003 786.9424Q3152.1216 786.9424 3167.5968000000003 779.8Q3183.072 772.6576 3190.8096 756.5872H3274.7328Q3259.8528 800.6320000000001 3223.8432000000003 825.9280000000001Q3187.8336 851.224 3131.2896 851.224Z M3318.1824 845.272V541.72H3405.6768V613.144H3407.4624000000003V845.272ZM3529.4784 845.272V657.1888Q3529.4784 632.1904000000001 3516.6816 619.6912Q3503.8848000000003 607.192 3479.4816 607.192Q3458.6496 607.192 3442.2816000000003 616.7152Q3425.9136000000003 626.2384 3416.688 642.904Q3407.4624000000003 659.5696 3407.4624000000003 682.1872000000001L3399.7248 608.9776Q3414.6048 575.6464000000001 3443.472 555.7072000000001Q3472.3392000000003 535.768 3514.5984000000003 535.768Q3565.1904000000004 535.768 3591.9744 564.04Q3618.7584 592.312 3618.7584 639.928V845.272Z M3889.5744000000004 845.272V778.0144L3895.5264 779.2048Q3889.5744000000004 811.9408000000001 3860.112 831.5824Q3830.6496 851.224 3789.5808 851.224Q3747.9168000000004 851.224 3717.264 831.8800000000001Q3686.6112000000003 812.5360000000001 3669.9456 777.4192Q3653.28 742.3024 3653.28 694.6864Q3653.28 646.4752000000001 3670.5408 610.7632000000001Q3687.8016000000002 575.0512 3719.0496000000003 555.4096Q3750.2976000000003 535.768 3791.9616000000005 535.768Q3835.4112000000005 535.768 3862.4928000000004 556.0048Q3889.5744000000004 576.2416000000001 3894.3360000000002 611.3584000000001L3887.7888000000003 611.9536V416.728H3977.0688000000005V845.272ZM3818.1504000000004 779.8000000000001Q3849.6960000000004 779.8000000000001 3869.3376000000003 757.48Q3888.9792 735.1600000000001 3888.9792 693.4960000000001Q3888.9792 651.832 3869.04 629.512Q3849.1008 607.192 3816.9600000000005 607.192Q3786.0096000000003 607.192 3766.0704000000005 629.8096Q3746.1312000000003 652.4272000000001 3746.1312000000003 694.0912000000001Q3746.1312000000003 735.7552000000001 3766.0704000000005 757.7776000000001Q3786.0096000000003 779.8000000000001 3818.1504000000004 779.8000000000001Z%22/%3E%3C/svg%3E)
Como a pesquisa web ao vivo garante a precisão do conteúdo em blogs automatizados
Sistemas de blog automatizado que utilizam pesquisa web ao vivo reduzem as taxas de alucinação em 73% a 86% por meio da recuperação de dados em tempo real. Este artigo explica como funciona a geração aumentada por recuperação (RAG) e por que isso é importante para o SEO.
Sistemas de blogging automatizado que dependem exclusivamente de grandes modelos de linguagem pré-treinados frequentemente produzem erros factuais e afirmações desatualizadas. A pesquisa web ao vivo para blogging automatizado, construída sobre arquiteturas de geração aumentada por recuperação, reduz as taxas de alucinação entre 73% e 86% ao integrar dados em tempo real no processo de geração, em vez de depender de pesos de treinamento estáticos.
Por Que o Conteúdo Automatizado Padrão Falha nos Fatos
Grandes modelos de linguagem geram texto prevendo os próximos tokens prováveis com base em padrões de treinamento. Isso cria uma prosa fluente, mas não garante a precisão. Quando um modelo não possui conhecimento paramétrico confiável para uma afirmação específica, ele alucina. Ele fabrica fatos, citações, datas ou estatísticas que soam plausíveis, mas são falsos.
Em benchmarks de domínio aberto como FActScore e SimpleQA, LLMs sem ancoragem alucinam em taxas entre 37% e 47% em tarefas de texto longo, segundo a análise de precisão da Suprmind de 2026. O problema se agrava em nichos de rápida evolução, onde os dados de treinamento não conseguem capturar desenvolvimentos recentes.
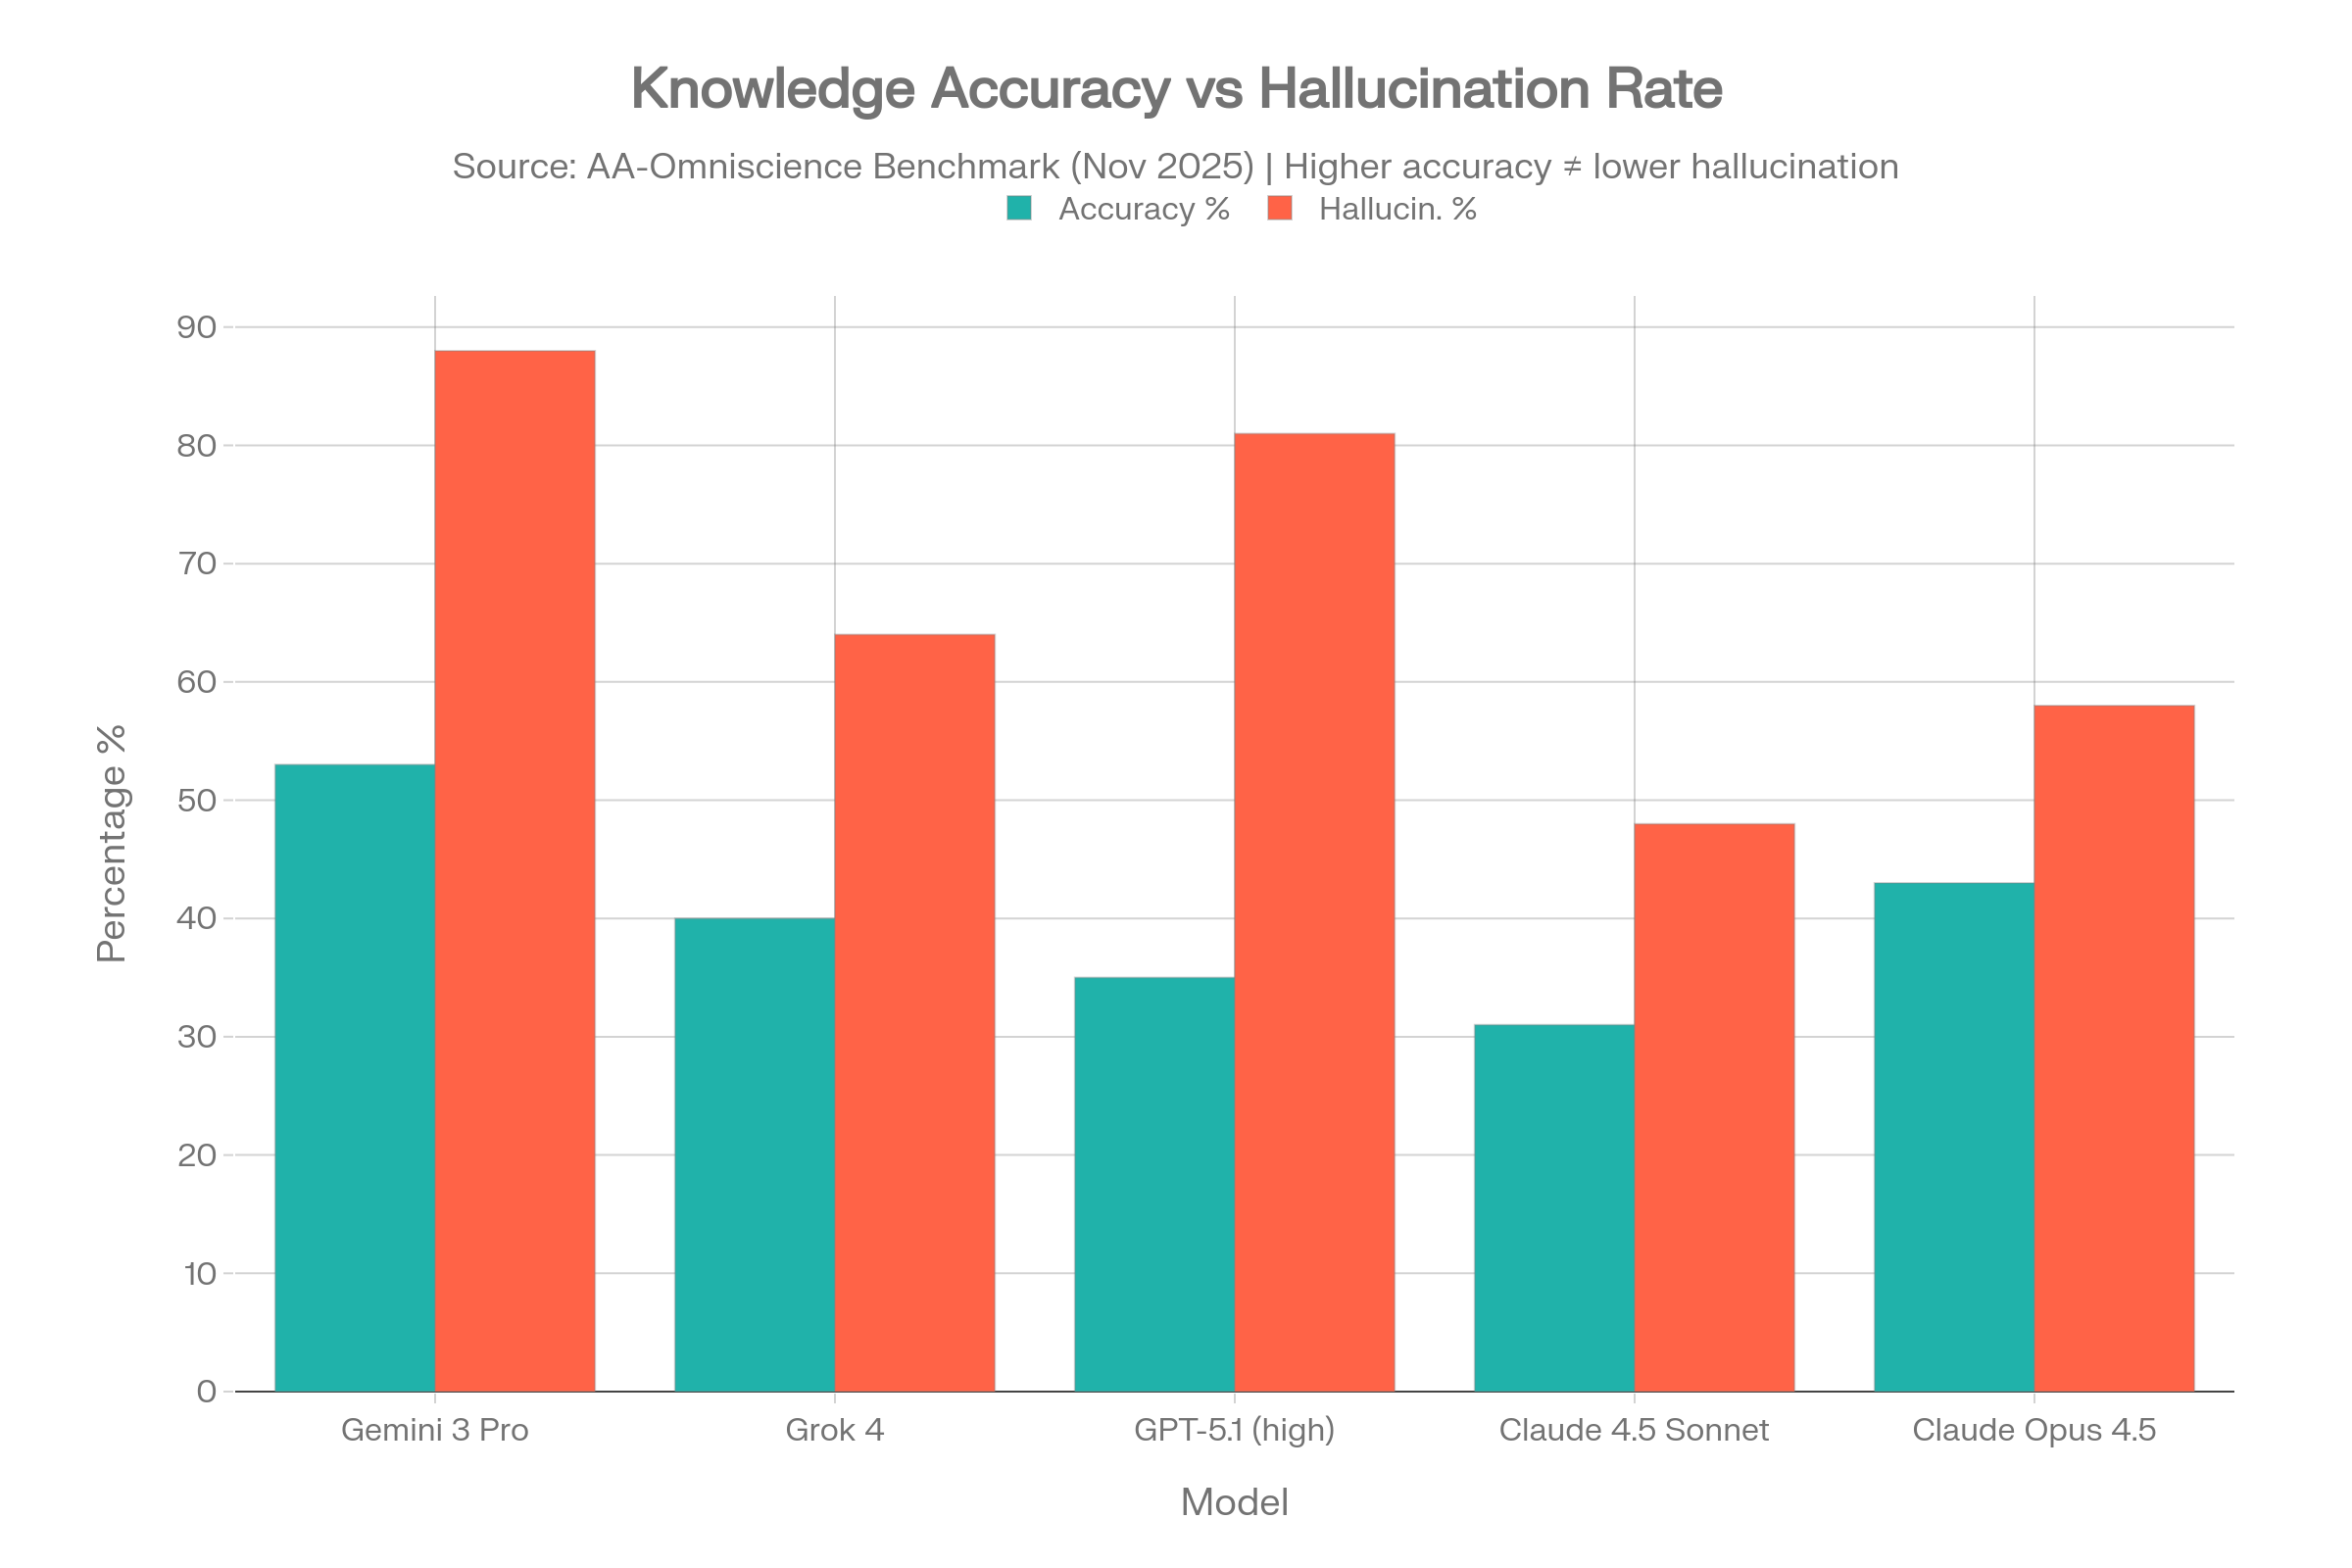
Modelos estáticos falham rotineiramente em:
- Preços atuais, taxas de câmbio e dados de mercado
- Regulamentações recém-promulgadas ou mudanças políticas
- Notícias de última hora e tendências emergentes
- Especificações e disponibilidade de produtos
- Estatísticas atualizadas de pesquisas em andamento
Sem recuperação de dados ao vivo, um post de blog automatizado sobre "limites de declaração de impostos de 2026" provavelmente propagará informações desatualizadas. Os leitores percebem, a confiança diminui e os mecanismos de busca penalizam conteúdo raso.
O Que Significa a Pesquisa Web ao Vivo para o Blogging Automatizado
A pesquisa web ao vivo na automação é a prática de consultar motores de busca, APIs e bancos de dados estruturados durante a geração de conteúdo. O sistema então injeta as informações recuperadas na janela de contexto do modelo. Isso depende da recuperação em tempo real, em vez do pré-processamento de uma base de conhecimento estática.
A técnica é chamada de Geração Aumentada por Recuperação (RAG). Formalizada pela primeira vez na pesquisa de Lewis et al. de 2020 sobre tarefas de PLN intensivas em conhecimento, a RAG separa a capacidade de raciocínio do modelo de linguagem de sua base de conhecimento factual. O modelo escreve; o sistema de recuperação fornece os fatos.
Stacks modernos de blogging automatizado usam duas camadas distintas de recuperação:
| Tipo de camada | Exemplos | Formato de saída | Mais adequado para |
|---|---|---|---|
| Recuperação web nativa de IA | Tavily, Exa, Linkup, Brave Search API | Markdown pré-limpo, resumos semânticos | Injeção direta no contexto do LLM |
| Scrapers tradicionais de SERP | SerpApi, Serper.dev, Firecrawl | Metadados brutos da SERP, requer análise HTML | Pipelines de extração personalizados |
A Microsoft aposentou a API independente de Busca Bing em 11 de agosto de 2025, acelerando a migração para alternativas nativas de IA. A Brave Search API indexa mais de 40 bilhões de páginas independentemente do Google ou Bing, oferecendo um corpus distinto para verificação.
O Pipeline de Pesquisa ao Vivo: Da Consulta ao Fato Publicado
Um pipeline RAG de produção para blogging automatizado segue cinco etapas sequenciais. Cada etapa adiciona latência, mas melhora a qualidade da saída.
- Formulação da consultaO sistema analisa o briefing do artigo e converte afirmações em consultas de busca específicas. "Discutir as alíquotas de imposto sobre ganhos de capital de 2026" torna-se consultas direcionadas para publicações do IRS e jornalismo financeiro verificado.
- Recuperação de fontesAs APIs de busca retornam resultados classificados. Pipelines avançados executam múltiplas consultas paralelas e aplicam reclassificação por cross-encoder para destacar as passagens mais relevantes.
- Injeção de contextoO texto recuperado é fragmentado, deduplicado e formatado para a janela de contexto do LLM. APIs nativas de IA como Tavily retornam markdown pré-estruturado otimizado para esta etapa.
- Geração ancoradaO modelo gera prosa restrita pelo contexto injetado. Ele pode citar, parafrasear ou sintetizar, mas suas afirmações factuais estão vinculadas às fontes recuperadas, em vez da memória paramétrica.
- Verificação e pontuaçãoA saída passa por checagem automática de fatos usando frameworks como a Tríade RAG (Fidelidade, Relevância da Resposta, Precisão do Contexto) e verificação de proposições atômicas via FActScore. O cross-encoder HHEM da Vectara sinaliza contradições factuais antes da publicação.
Essa latência é proibitiva para chatbots interativos, mas gerenciável para blogging automatizado. Pipelines de produção desacoplam a geração das requisições do usuário usando filas de trabalho assíncronas, como Celery ou BullMQ. Os artigos são gerados em segundo plano e publicados conforme agendamento.
Atribuição de Fontes e Sinais de Confiança
Conteúdo com pesquisa ao vivo inclui citações inline para fontes primárias. Isso permite que os leitores verifiquem as afirmações e sinaliza aos mecanismos de busca que o conteúdo é fundamentado.
A autoridade do domínio importa na seleção de fontes. Um pipeline que recupera dados de domínios .gov, organizações de notícias estabelecidas e periódicos revisados por pares produz resultados mais confiáveis do que um que raspa fóruns não moderados. Sistemas de produção filtram pela reputação do domínio e excluem fontes conhecidas por baixa credibilidade.
A diferença entre saída estática e saída com pesquisa ao vivo é gritante:
| Dimensão | Saída estática de LLM | Saída RAG com pesquisa ao vivo |
|---|---|---|
| Atualidade dos fatos | Congelada no ponto de corte do treinamento | Atual no momento da geração |
| Taxa de alucinação (FActScore) | 37–47% | Menos de 10% |
| Verificabilidade da fonte | Nenhuma | Citações inline para páginas recuperadas |
| Perfil de risco SEO | Alto: não original, potencialmente falso | Menor: fundamentado, atualizado |
| Sinais de confiança para o leitor | Afirmações genéricas, sem ancoragem | Fatos específicos, atribuídos |
Desempenho em SEO e a posição do Google sobre conteúdo automatizado
O Google não proíbe conteúdo gerado por IA. Ele proíbe conteúdo de baixa qualidade e manipulativo, independentemente do método de produção. A orientação oficial do Google afirma: "Recompensar conteúdo de qualidade, seja qual for a forma como foi produzido, tem sido central para a Busca há muitos anos."
No entanto, a atualização principal de março de 2024 elevou o nível de exigência. A empresa aposentou seu classificador independente de Sistema de Conteúdo Útil e absorveu os sinais de utilidade nos algoritmos principais de classificação. Introduziu a política de spam "Abuso de Conteúdo Escalado", definida como a geração de muitas páginas principalmente para manipular rankings de busca sem agregar valor para os usuários.
O abuso de conteúdo escalado ocorre quando muitas páginas são geradas com o objetivo principal de manipular rankings de busca e não ajudar os usuários. Essa prática abusiva geralmente se concentra na criação de grandes volumes de conteúdo não original que oferece pouco ou nenhum valor aos usuários, independentemente de como foi criado.
Documentação do Google Search Central, Políticas Oficiais de Spam na Web Search
A atualização de março de 2024 entregou resultados mensuráveis: o Google confirmou uma redução de 45% no conteúdo de baixa qualidade e não original aparecendo nos resultados de busca após a conclusão da implementação.
A pesquisa web ao vivo aborda diretamente os sinais de qualidade do Google. Conteúdo atual e atribuído demonstra Experiência, Expertise, Autoridade e Confiabilidade (E-E-A-T). Respostas precisas reduzem as taxas de rejeição porque os leitores encontram o que buscaram, em vez de se depararem com informações desatualizadas.
Armadilhas de implementação e como lidar com elas
Pesquisa ao vivo não significa automaticamente qualidade. Implementações ruins introduzem novos modos de falha.
Conteúdo pago e restrito
Sistemas de recuperação frequentemente encontram artigos de notícias pagos ou papers de pesquisa bloqueados. O título pode ser recuperado, mas o contexto factual completo fica inacessível. Pipelines de produção devem detectar indicadores de paywall e excluir essas fontes ou marcá-las para revisão humana, em vez de sintetizar a partir de informações incompletas.
Fontes conflitantes
A busca ao vivo pode retornar afirmações contraditórias de fontes igualmente credíveis. Pipelines robustos expõem esses conflitos em vez de selecionar arbitrariamente uma versão. O artigo gerado deve reconhecer a incerteza ou apresentar múltiplas perspectivas verificadas.
Contaminação por scrapers de baixa qualidade
Os resultados de busca incluem fazendas de conteúdo e resumos autogerados que carecem de reportagens originais. Sem filtragem, um pipeline RAG pode ingerir e regurgitar esse material. Listas permitidas de domínios, ponderação pela atualidade do conteúdo e deduplicação semântica ajudam a excluir ruído.
Limites de direitos autorais e uso justo
O scraping ao vivo levanta questões legais. Sistemas de recuperação baixam e armazenam temporariamente conteúdo web protegido por direitos autorais para análise. O uso justo geralmente protege cópias intermediárias para fins transformativos, como resumir, mas a reprodução integral infringe direitos autorais. Pipelines de blog automatizados devem:
- Limitar citações diretas a trechos breves e atribuídos
- Transformar as informações recuperadas através de síntese e estrutura originais
- Linkar para as fontes em vez de substituí-las
- Respeitar o robots.txt e os termos de serviço dos sites de destino
O valor agregado pela pesquisa ao vivo é a verificação e a atualidade. Sistemas que apenas republicam texto extraído sem transformação violam tanto as políticas de spam do Google quanto a lei de direitos autorais.
Avaliando se sua configuração precisa de pesquisa ao vivo
Nem todo post de blog exige recuperação em tempo real. Conteúdo evergreen (atemporal) sobre temas estabelecidos pode ser bem servido por bases de conhecimento estáticas e bem curadas. No entanto, a pesquisa ao vivo torna-se essencial quando o conteúdo abrange:
- Notícias sensíveis ao tempo e análise de tendências
- Dados financeiros, preços e condições de mercado
- Conformidade regulatória e requisitos legais
- Análises de produtos e especificações
- Inteligência competitiva e benchmarks do setor
- Cobertura de eventos e anúncios programados
Se seu blog automatizado opera nesses domínios e atualmente gera conteúdo sem fundamentação ao vivo, sua taxa de erro factual provavelmente se aproxima da linha de base de 37–47% documentada na pesquisa sobre alucinações de LLMs. A melhoria de 73% a 86% com a integração de RAG representa um upgrade direto de qualidade que leitores e mecanismos de busca detectarão.
O que verificar antes que seu próximo post automatizado vá ao ar
- Cada estatística, data e nome próprio pode ser rastreada até uma fonte recuperada com uma URL funcional?
- As fontes vêm de domínios confiáveis, em vez de fóruns não verificados ou fazendas de conteúdo?
- O artigo adiciona estrutura original e síntese, ou apenas reorganiza frases extraídas?
- Você verificou se nenhuma fonte paga foi citada sem evidências acessíveis?
- A informação está atualizada no momento da geração, ou a defasagem devido ao corte de treinamento pode ter ocorrido?
Blogging automatizado em escala exige mais do que geração de texto fluente. Exige uma camada de verificação que conecte cada afirmação à web ao vivo. Se você está avaliando plataformas, compare planos que incluem infraestrutura de pesquisa ao vivo contra aqueles que dependem apenas da saída estática do modelo. Para equipes prontas para implementar, comece agora com um sistema que fundamenta a geração em dados em tempo real desde o primeiro artigo.
Continue lendo
Veja mais sobre Automação de Blogs
- Blog AutomationOct 4, 2026
Web Integration for Blog Automation: How to Choose the Right Tools
Web integration for blog automation connects content generation pipelines to CMS platforms through APIs and middleware, eliminating manual copy-pasting and enabling scalable publishing workflows.
Leia o artigo - Fluxos de trabalho de publicaçãoOct 4, 2026
Como implementar automação de conteúdo com pesquisa web ao vivo para pipelines de escrita com IA
Aprenda a criar um pipeline de pesquisa web ao vivo que conecta APIs de busca em tempo real a sistemas de escrita com LLMs, com etapas específicas para extração de dados, fundamentação em fontes, atribuição automática e validação pré-publicação.
Leia o artigo - WordPressOct 4, 2026
Pipelines de conteúdo automatizados no WordPress: integração e fluxo de trabalho
A criação automatizada de conteúdo no WordPress usa a REST API para publicar artigos otimizados e pesquisados por IA diretamente no seu site. Isso transforma o blogueiro de escritor em estrategista editorial, supervisionando prompts, fatos e critérios de qualidade.
Leia o artigo