 scale(0.100000,-0.100000)%22%3E%3Cpath d=%22M4297 11020 c-251 -23 -537 -106 -727 -212 -443 -246 -736 -645 -826 -1123 -18 -97 -19 -207 -19 -3245 0 -3437 -4 -3204 61 -3464 145 -585 533 -1052 1103 -1330 52 -25 105 -46 118 -46 39 0 90 26 110 56 17 27 18 80 24 959 5 900 6 934 28 1060 53 314 144 569 297 832 219 376 589 741 999 983 50 29 119 70 155 91 177 104 553 265 830 353 495 159 1130 272 1651 293 l156 6 -3 -229 c-7 -645 -130 -1193 -376 -1677 -155 -306 -373 -585 -598 -766 -329 -265 -571 -377 -1169 -542 -500 -137 -709 -225 -974 -409 -116 -80 -331 -295 -415 -415 -113 -160 -204 -370 -238 -552 -15 -79 -14 -89 1 -129 10 -28 28 -51 49 -64 33 -20 41 -20 1478 -20 1442 0 1599 3 1808 36 677 106 1325 449 1770 938 130 141 202 234 296 376 549 834 695 1868 404 2865 -103 350 -280 710 -483 980 -361 479 -868 808 -1442 935 -328 73 -460 80 -1577 80 l-908 0 0 1108 c0 1199 0 1198 -55 1387 -76 262 -240 486 -464 636 -134 90 -197 122 -340 169 -216 72 -482 102 -724 80z%22/%3E%3Cpath d=%22M6314 10340 c-26 -10 -72 -65 -79 -93 -3 -12 -4 -400 -3 -862 l3 -840 28 -79 c78 -222 264 -396 497 -467 l75 -23 867 -4 c958 -3 918 -6 958 60 11 18 20 45 20 60 0 60 79 -22 -1100 1143 -927 916 -1090 1075 -1122 1095 -34 21 -105 26 -144 10z%22/%3E%3C/g%3E%3C/g%3E%3Cpath fill=%22%230B1220%22 d=%22M1436.7552 845.272V779.8000000000001H1547.4624000000001Q1577.2224 779.8000000000001 1592.4 763.432Q1607.5776 747.0640000000001 1607.5776 717.8992000000001Q1607.5776 688.1392000000001 1591.2096000000001 670.8784Q1574.8416 653.6176 1544.4864 653.6176H1436.7552V588.1456000000001H1539.7248Q1567.6992 588.1456000000001 1582.2816 574.7536Q1596.864 561.3616 1596.864 535.1728Q1596.864 508.98400000000004 1582.8768 495.592Q1568.8896 482.2 1541.5104000000001 482.2H1436.7552V416.728H1561.152Q1618.2912000000001 416.728 1653.4080000000001 445.8928Q1688.5248000000001 475.05760000000004 1688.5248000000001 525.0544Q1688.5248000000001 556.6 1673.6448 579.2176Q1658.7648 601.8352 1633.7664 613.7392Q1608.768 625.6432 1577.8176 625.6432L1580.7936 613.144Q1614.1248 613.144 1641.2064 627.4288Q1668.288 641.7136 1684.3584 667.6048000000001Q1700.4288000000001 693.4960000000001 1700.4288000000001 728.6128Q1700.4288000000001 763.7296 1684.0608000000002 790.216Q1667.6928 816.7024 1638.2304 830.9872Q1608.768 845.272 1568.8896 845.272ZM1361.76 845.272V416.728H1453.4208V845.272Z M1742.0928 845.272V416.728H1831.3727999999999V845.272Z M2034.9312 851.224Q1984.9343999999999 851.224 1947.1391999999998 831.2848000000001Q1909.3439999999998 811.3456000000001 1888.2143999999998 775.336Q1867.0847999999999 739.3264 1867.0847999999999 692.3056Q1867.0847999999999 645.2848 1888.2143999999998 610.168Q1909.3439999999998 575.0512 1947.1391999999998 555.4096Q1984.9343999999999 535.768 2034.9312 535.768Q2085.5232 535.768 2123.3184 555.4096Q2161.1135999999997 575.0512 2181.9456 610.168Q2202.7776 645.2848 2202.7776 692.3056Q2202.7776 739.3264 2181.648 775.336Q2160.5184 811.3456000000001 2122.7232 831.2848000000001Q2084.928 851.224 2034.9312 851.224ZM2034.9312 780.9904Q2055.7632 780.9904 2072.7263999999996 770.2768000000001Q2089.6895999999997 759.5632 2099.808 739.624Q2109.9264 719.6848 2109.9264 691.7104Q2109.9264 650.6416 2088.2016 628.3216Q2066.4768 606.0016 2034.9312 606.0016Q2003.3855999999998 606.0016 1981.6607999999999 628.6192000000001Q1959.936 651.2368 1959.936 691.7104Q1959.936 719.6848 1970.0544 739.624Q1980.1727999999998 759.5632 1997.136 770.2768000000001Q2014.0991999999999 780.9904 2034.9312 780.9904Z M2378.3615999999997 973.24Q2315.2704 973.24 2275.6895999999997 946.456Q2236.1088 919.672 2228.9664 873.8416000000001H2313.4847999999997Q2318.2464 885.1504000000001 2334.0191999999997 891.1024000000001Q2349.792 897.0544000000001 2374.1952 897.0544000000001Q2414.6688 897.0544000000001 2433.12 881.5792000000001Q2451.5712 866.104 2451.5712 833.368V767.3008L2456.3328 768.4912Q2450.3808 801.8224 2421.8112 821.1664000000001Q2393.2416 840.5104 2350.9824 840.5104Q2310.5088 840.5104 2280.4512 821.7616Q2250.3936 803.0128000000001 2233.728 769.0864000000001Q2217.0624 735.1600000000001 2217.0624 689.3296Q2217.0624 642.904 2234.3232 608.3824Q2251.584 573.8608 2282.832 554.8144Q2314.08 535.768 2355.7439999999997 535.768Q2398.5984 535.768 2425.68 556.0048Q2452.7616 576.2416000000001 2457.5232 611.3584000000001L2453.3568 611.9536V541.72H2540.8512V832.1776000000001Q2540.8512 897.6496000000001 2497.4016 935.4448Q2453.9519999999998 973.24 2378.3615999999997 973.24ZM2381.9328 772.0624Q2413.4784 772.0624 2433.12 750.3376000000001Q2452.7616 728.6128 2452.7616 688.1392000000001Q2452.7616 647.6656 2432.8224 625.9408000000001Q2412.8831999999998 604.216 2380.7424 604.216Q2349.792 604.216 2329.8527999999997 626.2384Q2309.9136 648.2608 2309.9136 688.7344Q2309.9136 729.2080000000001 2329.8527999999997 750.6352Q2349.792 772.0624 2381.9328 772.0624Z%22/%3E%3Cpath fill=%22%231F63F5%22 d=%22M2718.8160000000003 845.272V486.96160000000003H2578.944V416.728H2950.3488V486.96160000000003H2810.4768V845.272Z M3131.2896 851.224Q3080.6976 851.224 3043.2 831.2848000000001Q3005.7024 811.3456000000001 2985.168 775.6336000000001Q2964.6336 739.9216 2964.6336 693.4960000000001Q2964.6336 646.4752000000001 2985.168 611.0608000000001Q3005.7024 575.6464000000001 3042.6048 555.7072000000001Q3079.5072 535.768 3128.3136 535.768Q3175.3344 535.768 3209.856 554.8144Q3244.3776000000003 573.8608 3263.424 607.7872Q3282.4704 641.7136 3282.4704 687.5440000000001Q3282.4704 697.0672000000001 3281.8752000000004 705.1024Q3281.28 713.1376 3280.0896000000002 720.28H3017.0112V661.3552H3208.0704L3192.5952 672.0688Q3192.5952 635.1664000000001 3175.0368 617.6080000000001Q3157.4784 600.0496 3127.1232 600.0496Q3092.0064 600.0496 3072.6624 623.8576Q3053.3184 647.6656 3053.3184 695.2816Q3053.3184 741.7072000000001 3072.6624 764.3248000000001Q3092.0064 786.9424 3130.6944000000003 786.9424Q3152.1216 786.9424 3167.5968000000003 779.8Q3183.072 772.6576 3190.8096 756.5872H3274.7328Q3259.8528 800.6320000000001 3223.8432000000003 825.9280000000001Q3187.8336 851.224 3131.2896 851.224Z M3318.1824 845.272V541.72H3405.6768V613.144H3407.4624000000003V845.272ZM3529.4784 845.272V657.1888Q3529.4784 632.1904000000001 3516.6816 619.6912Q3503.8848000000003 607.192 3479.4816 607.192Q3458.6496 607.192 3442.2816000000003 616.7152Q3425.9136000000003 626.2384 3416.688 642.904Q3407.4624000000003 659.5696 3407.4624000000003 682.1872000000001L3399.7248 608.9776Q3414.6048 575.6464000000001 3443.472 555.7072000000001Q3472.3392000000003 535.768 3514.5984000000003 535.768Q3565.1904000000004 535.768 3591.9744 564.04Q3618.7584 592.312 3618.7584 639.928V845.272Z M3889.5744000000004 845.272V778.0144L3895.5264 779.2048Q3889.5744000000004 811.9408000000001 3860.112 831.5824Q3830.6496 851.224 3789.5808 851.224Q3747.9168000000004 851.224 3717.264 831.8800000000001Q3686.6112000000003 812.5360000000001 3669.9456 777.4192Q3653.28 742.3024 3653.28 694.6864Q3653.28 646.4752000000001 3670.5408 610.7632000000001Q3687.8016000000002 575.0512 3719.0496000000003 555.4096Q3750.2976000000003 535.768 3791.9616000000005 535.768Q3835.4112000000005 535.768 3862.4928000000004 556.0048Q3889.5744000000004 576.2416000000001 3894.3360000000002 611.3584000000001L3887.7888000000003 611.9536V416.728H3977.0688000000005V845.272ZM3818.1504000000004 779.8000000000001Q3849.6960000000004 779.8000000000001 3869.3376000000003 757.48Q3888.9792 735.1600000000001 3888.9792 693.4960000000001Q3888.9792 651.832 3869.04 629.512Q3849.1008 607.192 3816.9600000000005 607.192Q3786.0096000000003 607.192 3766.0704000000005 629.8096Q3746.1312000000003 652.4272000000001 3746.1312000000003 694.0912000000001Q3746.1312000000003 735.7552000000001 3766.0704000000005 757.7776000000001Q3786.0096000000003 779.8000000000001 3818.1504000000004 779.8000000000001Z%22/%3E%3C/svg%3E)
 scale(0.100000,-0.100000)%22%3E%3Cpath d=%22M4297 11020 c-251 -23 -537 -106 -727 -212 -443 -246 -736 -645 -826 -1123 -18 -97 -19 -207 -19 -3245 0 -3437 -4 -3204 61 -3464 145 -585 533 -1052 1103 -1330 52 -25 105 -46 118 -46 39 0 90 26 110 56 17 27 18 80 24 959 5 900 6 934 28 1060 53 314 144 569 297 832 219 376 589 741 999 983 50 29 119 70 155 91 177 104 553 265 830 353 495 159 1130 272 1651 293 l156 6 -3 -229 c-7 -645 -130 -1193 -376 -1677 -155 -306 -373 -585 -598 -766 -329 -265 -571 -377 -1169 -542 -500 -137 -709 -225 -974 -409 -116 -80 -331 -295 -415 -415 -113 -160 -204 -370 -238 -552 -15 -79 -14 -89 1 -129 10 -28 28 -51 49 -64 33 -20 41 -20 1478 -20 1442 0 1599 3 1808 36 677 106 1325 449 1770 938 130 141 202 234 296 376 549 834 695 1868 404 2865 -103 350 -280 710 -483 980 -361 479 -868 808 -1442 935 -328 73 -460 80 -1577 80 l-908 0 0 1108 c0 1199 0 1198 -55 1387 -76 262 -240 486 -464 636 -134 90 -197 122 -340 169 -216 72 -482 102 -724 80z%22/%3E%3Cpath d=%22M6314 10340 c-26 -10 -72 -65 -79 -93 -3 -12 -4 -400 -3 -862 l3 -840 28 -79 c78 -222 264 -396 497 -467 l75 -23 867 -4 c958 -3 918 -6 958 60 11 18 20 45 20 60 0 60 79 -22 -1100 1143 -927 916 -1090 1075 -1122 1095 -34 21 -105 26 -144 10z%22/%3E%3C/g%3E%3C/g%3E%3Cpath fill=%22%23FFFFFF%22 d=%22M1436.7552 845.272V779.8000000000001H1547.4624000000001Q1577.2224 779.8000000000001 1592.4 763.432Q1607.5776 747.0640000000001 1607.5776 717.8992000000001Q1607.5776 688.1392000000001 1591.2096000000001 670.8784Q1574.8416 653.6176 1544.4864 653.6176H1436.7552V588.1456000000001H1539.7248Q1567.6992 588.1456000000001 1582.2816 574.7536Q1596.864 561.3616 1596.864 535.1728Q1596.864 508.98400000000004 1582.8768 495.592Q1568.8896 482.2 1541.5104000000001 482.2H1436.7552V416.728H1561.152Q1618.2912000000001 416.728 1653.4080000000001 445.8928Q1688.5248000000001 475.05760000000004 1688.5248000000001 525.0544Q1688.5248000000001 556.6 1673.6448 579.2176Q1658.7648 601.8352 1633.7664 613.7392Q1608.768 625.6432 1577.8176 625.6432L1580.7936 613.144Q1614.1248 613.144 1641.2064 627.4288Q1668.288 641.7136 1684.3584 667.6048000000001Q1700.4288000000001 693.4960000000001 1700.4288000000001 728.6128Q1700.4288000000001 763.7296 1684.0608000000002 790.216Q1667.6928 816.7024 1638.2304 830.9872Q1608.768 845.272 1568.8896 845.272ZM1361.76 845.272V416.728H1453.4208V845.272Z M1742.0928 845.272V416.728H1831.3727999999999V845.272Z M2034.9312 851.224Q1984.9343999999999 851.224 1947.1391999999998 831.2848000000001Q1909.3439999999998 811.3456000000001 1888.2143999999998 775.336Q1867.0847999999999 739.3264 1867.0847999999999 692.3056Q1867.0847999999999 645.2848 1888.2143999999998 610.168Q1909.3439999999998 575.0512 1947.1391999999998 555.4096Q1984.9343999999999 535.768 2034.9312 535.768Q2085.5232 535.768 2123.3184 555.4096Q2161.1135999999997 575.0512 2181.9456 610.168Q2202.7776 645.2848 2202.7776 692.3056Q2202.7776 739.3264 2181.648 775.336Q2160.5184 811.3456000000001 2122.7232 831.2848000000001Q2084.928 851.224 2034.9312 851.224ZM2034.9312 780.9904Q2055.7632 780.9904 2072.7263999999996 770.2768000000001Q2089.6895999999997 759.5632 2099.808 739.624Q2109.9264 719.6848 2109.9264 691.7104Q2109.9264 650.6416 2088.2016 628.3216Q2066.4768 606.0016 2034.9312 606.0016Q2003.3855999999998 606.0016 1981.6607999999999 628.6192000000001Q1959.936 651.2368 1959.936 691.7104Q1959.936 719.6848 1970.0544 739.624Q1980.1727999999998 759.5632 1997.136 770.2768000000001Q2014.0991999999999 780.9904 2034.9312 780.9904Z M2378.3615999999997 973.24Q2315.2704 973.24 2275.6895999999997 946.456Q2236.1088 919.672 2228.9664 873.8416000000001H2313.4847999999997Q2318.2464 885.1504000000001 2334.0191999999997 891.1024000000001Q2349.792 897.0544000000001 2374.1952 897.0544000000001Q2414.6688 897.0544000000001 2433.12 881.5792000000001Q2451.5712 866.104 2451.5712 833.368V767.3008L2456.3328 768.4912Q2450.3808 801.8224 2421.8112 821.1664000000001Q2393.2416 840.5104 2350.9824 840.5104Q2310.5088 840.5104 2280.4512 821.7616Q2250.3936 803.0128000000001 2233.728 769.0864000000001Q2217.0624 735.1600000000001 2217.0624 689.3296Q2217.0624 642.904 2234.3232 608.3824Q2251.584 573.8608 2282.832 554.8144Q2314.08 535.768 2355.7439999999997 535.768Q2398.5984 535.768 2425.68 556.0048Q2452.7616 576.2416000000001 2457.5232 611.3584000000001L2453.3568 611.9536V541.72H2540.8512V832.1776000000001Q2540.8512 897.6496000000001 2497.4016 935.4448Q2453.9519999999998 973.24 2378.3615999999997 973.24ZM2381.9328 772.0624Q2413.4784 772.0624 2433.12 750.3376000000001Q2452.7616 728.6128 2452.7616 688.1392000000001Q2452.7616 647.6656 2432.8224 625.9408000000001Q2412.8831999999998 604.216 2380.7424 604.216Q2349.792 604.216 2329.8527999999997 626.2384Q2309.9136 648.2608 2309.9136 688.7344Q2309.9136 729.2080000000001 2329.8527999999997 750.6352Q2349.792 772.0624 2381.9328 772.0624Z%22/%3E%3Cpath fill=%22%235B93FF%22 d=%22M2718.8160000000003 845.272V486.96160000000003H2578.944V416.728H2950.3488V486.96160000000003H2810.4768V845.272Z M3131.2896 851.224Q3080.6976 851.224 3043.2 831.2848000000001Q3005.7024 811.3456000000001 2985.168 775.6336000000001Q2964.6336 739.9216 2964.6336 693.4960000000001Q2964.6336 646.4752000000001 2985.168 611.0608000000001Q3005.7024 575.6464000000001 3042.6048 555.7072000000001Q3079.5072 535.768 3128.3136 535.768Q3175.3344 535.768 3209.856 554.8144Q3244.3776000000003 573.8608 3263.424 607.7872Q3282.4704 641.7136 3282.4704 687.5440000000001Q3282.4704 697.0672000000001 3281.8752000000004 705.1024Q3281.28 713.1376 3280.0896000000002 720.28H3017.0112V661.3552H3208.0704L3192.5952 672.0688Q3192.5952 635.1664000000001 3175.0368 617.6080000000001Q3157.4784 600.0496 3127.1232 600.0496Q3092.0064 600.0496 3072.6624 623.8576Q3053.3184 647.6656 3053.3184 695.2816Q3053.3184 741.7072000000001 3072.6624 764.3248000000001Q3092.0064 786.9424 3130.6944000000003 786.9424Q3152.1216 786.9424 3167.5968000000003 779.8Q3183.072 772.6576 3190.8096 756.5872H3274.7328Q3259.8528 800.6320000000001 3223.8432000000003 825.9280000000001Q3187.8336 851.224 3131.2896 851.224Z M3318.1824 845.272V541.72H3405.6768V613.144H3407.4624000000003V845.272ZM3529.4784 845.272V657.1888Q3529.4784 632.1904000000001 3516.6816 619.6912Q3503.8848000000003 607.192 3479.4816 607.192Q3458.6496 607.192 3442.2816000000003 616.7152Q3425.9136000000003 626.2384 3416.688 642.904Q3407.4624000000003 659.5696 3407.4624000000003 682.1872000000001L3399.7248 608.9776Q3414.6048 575.6464000000001 3443.472 555.7072000000001Q3472.3392000000003 535.768 3514.5984000000003 535.768Q3565.1904000000004 535.768 3591.9744 564.04Q3618.7584 592.312 3618.7584 639.928V845.272Z M3889.5744000000004 845.272V778.0144L3895.5264 779.2048Q3889.5744000000004 811.9408000000001 3860.112 831.5824Q3830.6496 851.224 3789.5808 851.224Q3747.9168000000004 851.224 3717.264 831.8800000000001Q3686.6112000000003 812.5360000000001 3669.9456 777.4192Q3653.28 742.3024 3653.28 694.6864Q3653.28 646.4752000000001 3670.5408 610.7632000000001Q3687.8016000000002 575.0512 3719.0496000000003 555.4096Q3750.2976000000003 535.768 3791.9616000000005 535.768Q3835.4112000000005 535.768 3862.4928000000004 556.0048Q3889.5744000000004 576.2416000000001 3894.3360000000002 611.3584000000001L3887.7888000000003 611.9536V416.728H3977.0688000000005V845.272ZM3818.1504000000004 779.8000000000001Q3849.6960000000004 779.8000000000001 3869.3376000000003 757.48Q3888.9792 735.1600000000001 3888.9792 693.4960000000001Q3888.9792 651.832 3869.04 629.512Q3849.1008 607.192 3816.9600000000005 607.192Q3786.0096000000003 607.192 3766.0704000000005 629.8096Q3746.1312000000003 652.4272000000001 3746.1312000000003 694.0912000000001Q3746.1312000000003 735.7552000000001 3766.0704000000005 757.7776000000001Q3786.0096000000003 779.8000000000001 3818.1504000000004 779.8000000000001Z%22/%3E%3C/svg%3E)
Hoe live webonderzoek de nauwkeurigheid van content bij geautomatiseerd bloggen waarborgt
Geautomatiseerde blogsysteem die gebruikmaken van live webonderzoek verminderen het aantal hallucinaties met 73% tot 86% door real-time dataophaaling. Dit artikel legt uit hoe retrieval-augmented generation werkt en waarom dit belangrijk is voor SEO.
Geautomatiseerde blogsysteem die uitsluitend vertrouwen op vooraf getrainde grote taalmodellen, produceren vaak feitelijke fouten en verouderde beweringen. Live webonderzoek voor geautomatiseerd bloggen, gebouwd op retrieval-augmented generation-architecturen (RAG), verlaagt het hallucinatiepercentage met 73% tot 86% door realtime data te integreren in het generatieproces in plaats van afhankelijk te zijn van statische trainingsgewichten.
Waarom standaard geautomatiseerde content faalt op feiten
Grote taalmodellen genereren tekst door waarschijnlijke volgende tokens te voorspellen op basis van trainingspatronen. Dit levert vloeiende proza op, maar garandeert geen nauwkeurigheid. Als een model geen betrouwbare parametrische kennis heeft voor een specifieke bewering, gaat het hallucineren. Het verzint feiten, citaten, data of statistieken die plausibel klinken maar onjuist zijn.
Op open-domein benchmarks zoals FActScore en SimpleQA hallucineren niet-onderbouwde LLM's volgens Suprmind's analyse van de nauwkeurigheid uit 2026 tussen de 37% en 47% van de tijd bij long-form taken. Het probleem verergert in snel bewegende niches waar trainingsdata recente ontwikkelingen niet kan vangen.
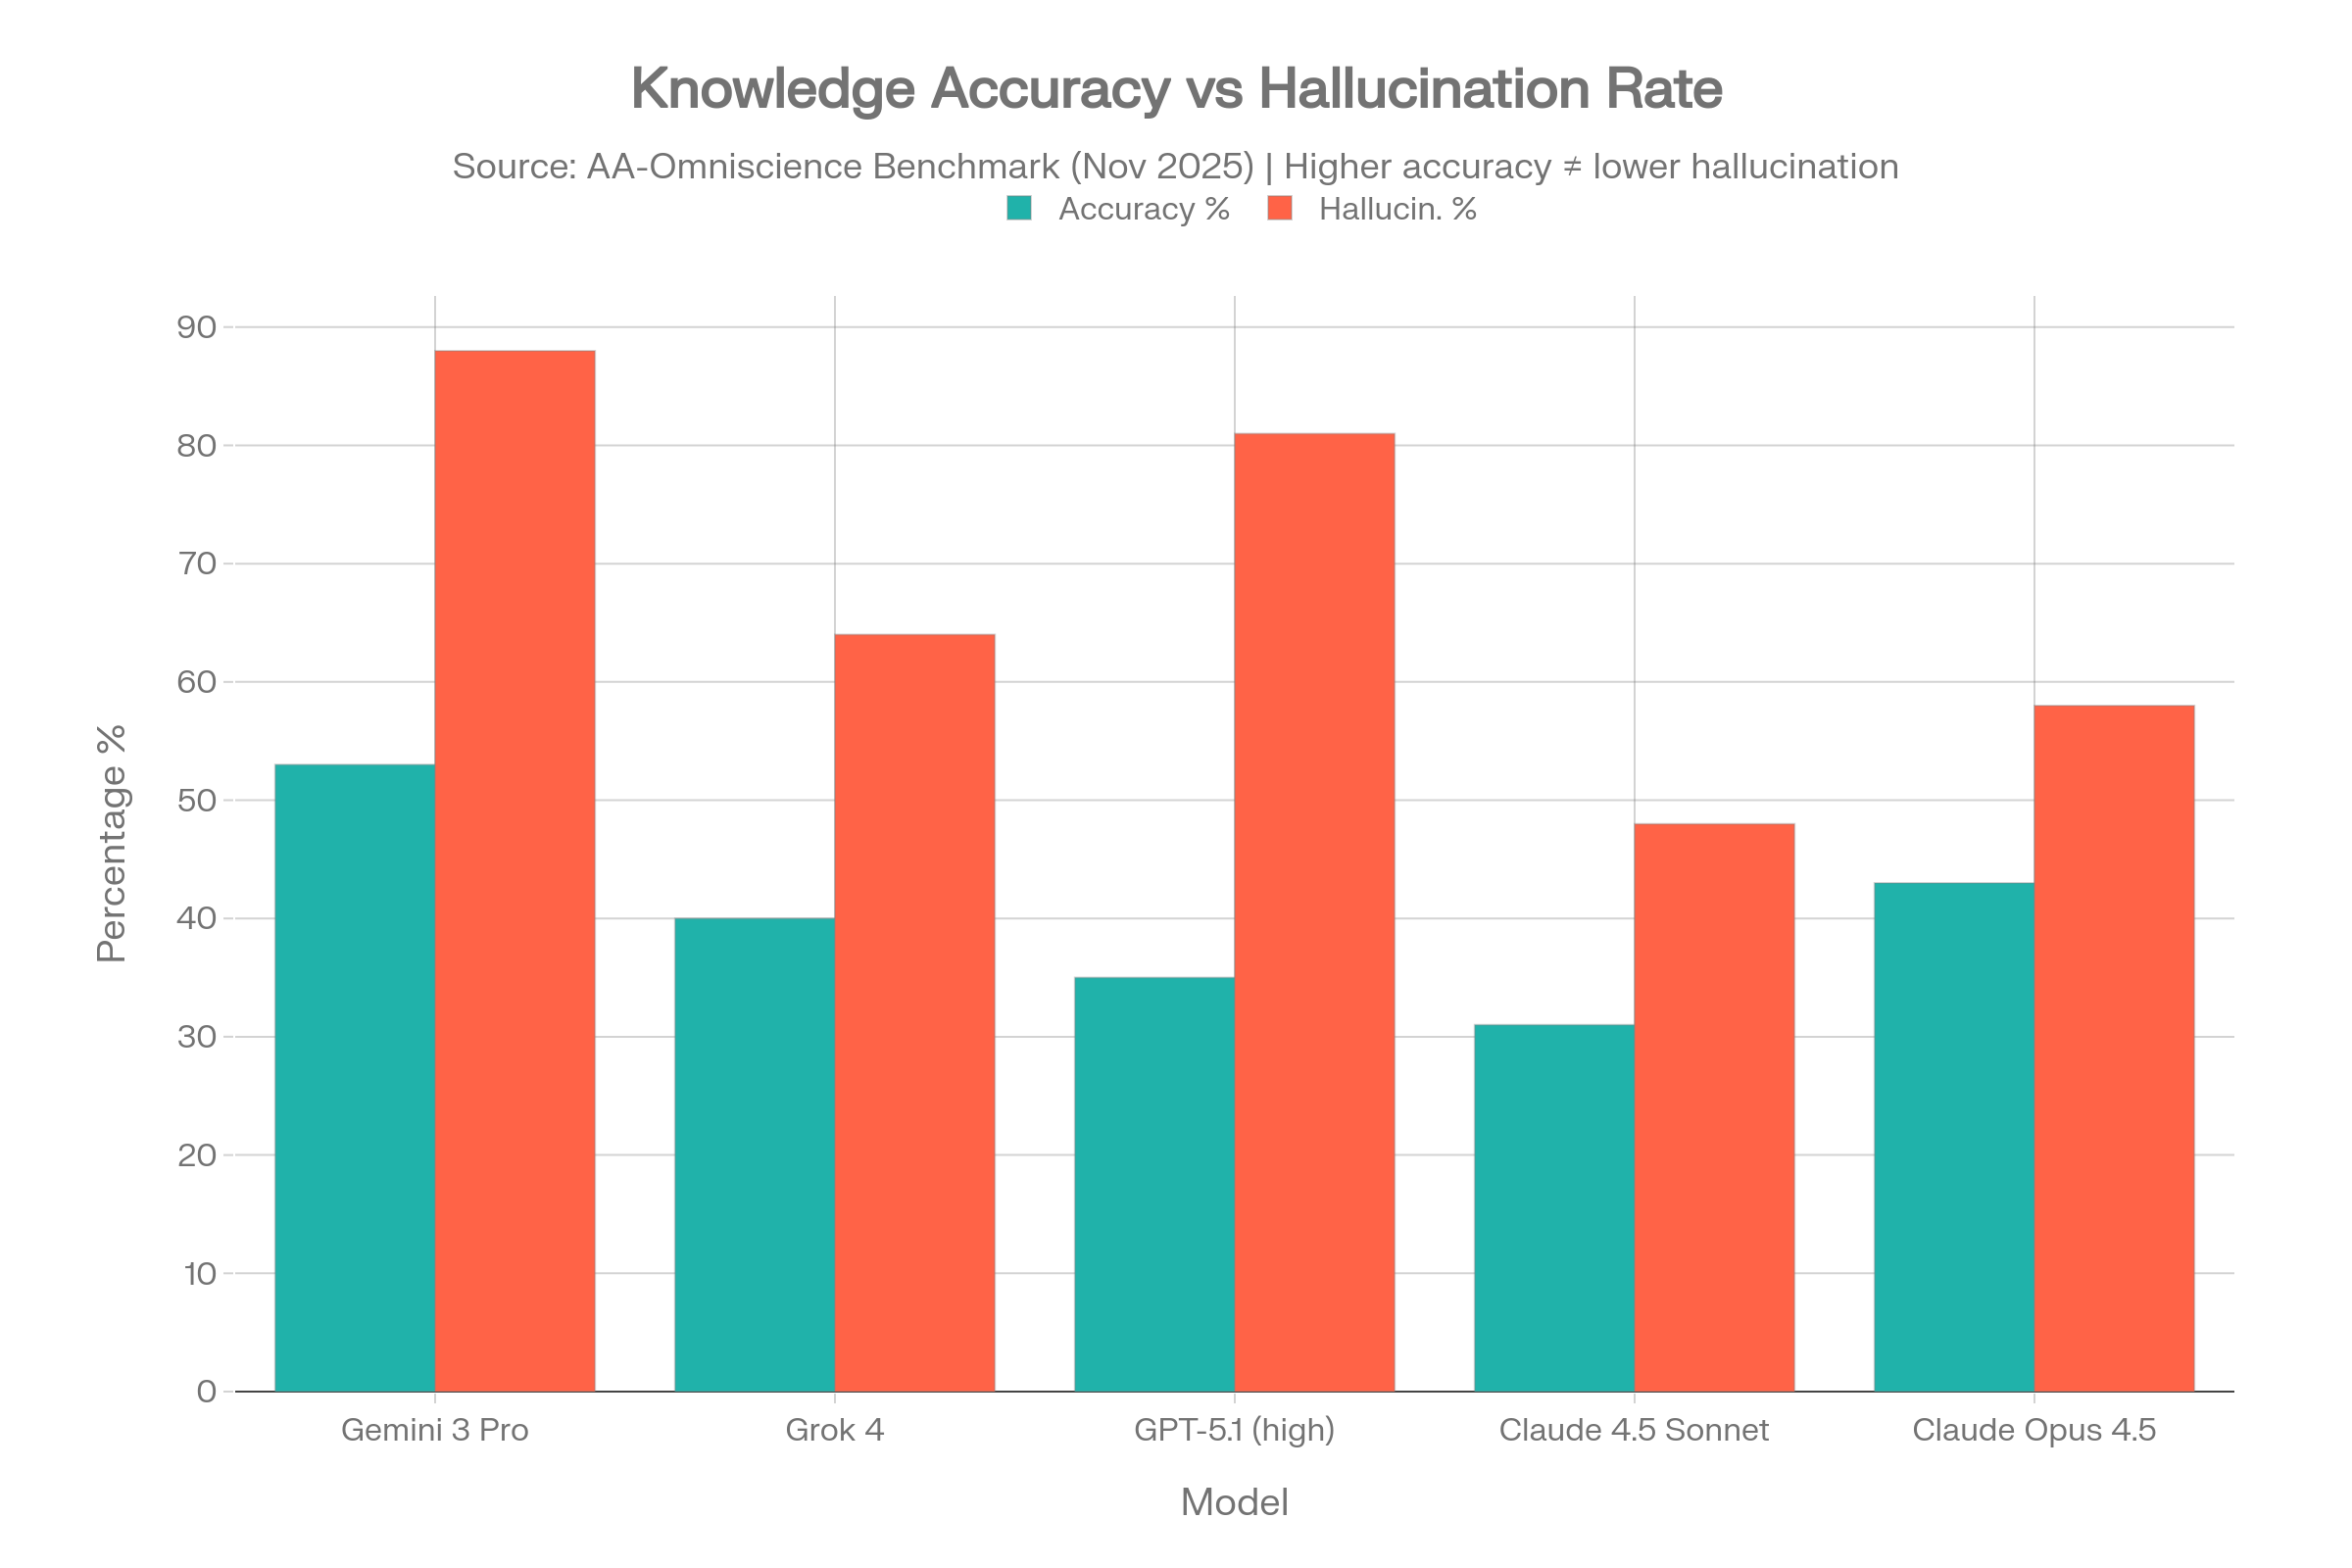
Statische modellen falen routinematig op:
- Huidige prijzen, wisselkoersen en marktgegevens
- Recent ingevoerde regelgeving of beleidswijzigingen
- Laatste nieuws en opkomende trends
- Productspecificaties en beschikbaarheid
- Bijgewerkte statistieken uit lopend onderzoek
Zonder live data-opvraging zal een geautomatiseerd blogartikel over "aangifte drempels voor belastingjaar 2026" waarschijnlijk verouderde informatie verspreiden. Lezers merken dit op, vertrouwen neemt af en zoekmachines straffen dunne content.
Wat live webonderzoek betekent voor geautomatiseerd bloggen
Live webonderzoek in automatisering is de praktijk van het raadplegen van zoekmachines, API's en gestructureerde databases tijdens het genereren van content. Het systeem injecteert vervolgens de opgehaalde informatie in de contextvenster van het model. Dit vertrouwt op realtime retrieval in plaats van het voorverwerken van een statische kennisbank.
Deze techniek heet Retrieval-Augmented Generation (RAG). Voor het eerst formeel beschreven in Lewis et al.'s onderzoek uit 2020 over kennisintensieve NLP-taken, scheidt RAG het redeneervermogen van het taalmodel van zijn feitelijke kennisbasis. Het model schrijft; het retrieval-systeem levert de feiten.
Moderne geautomatiseerde blogging-stacks gebruiken twee verschillende retrieval-lagen:
| Type laag | Voorbeelden | Uitvoerformaat | Best geschikt voor |
|---|---|---|---|
| AI-native web retrieval | Tavily, Exa, Linkup, Brave Search API | Voorgeschone markdown, semantische samenvattingen | Directe LLM-contextinjectie |
| Traditionele SERP-scrapers | SerpApi, Serper.dev, Firecrawl | Ruwe SERP-metadata, vereist HTML-parsing | Aangepaste extractie-pipelines |
Microsoft heeft de standalone Bing Search API op 11 augustus 2025 stopgezet, wat de migratie naar AI-native alternatieven versnelt. De Brave Search API indexeert meer dan 40 miljard pagina's onafhankelijk van Google of Bing, en biedt een distinctief corpus voor verificatie.
De Live Research Pipeline: Van query tot gepubliceerd feit
Een productie-RAG-pipeline voor geautomatiseerd bloggen volgt vijf sequentiële fasen. Elke fase voegt latentie toe maar verbetert de uitvoerkwaliteit.
- Query formuleringHet systeem analyseert de artikelbrief en vertoont claims naar specifieke zoekopdrachten. "Bespreking van kapitaalwinstbelastingtarieven voor 2026" wordt gerichte queries voor IRS-publicaties en geverifieerde financiële journalistiek.
- Bron retrievalZoek-API's retourneren gerangschikte resultaten. Geavanceerde pipelines voeren meerdere parallelle queries uit en passen cross-encoder reranking toe om de meest relevante passages boven water te halen.
- Context injectieOpgehaalde tekst wordt chunked, gededupliceerd en geformatteerd voor het contextvenster van de LLM. AI-native API's zoals Tavily retourneren voorgestructureerde markdown die geoptimaliseerd is voor deze stap.
- Onderbouwde generatieHet model genereert proza dat beperkt wordt door de geïnjecteerde context. Het kan citeren, parafraseren of synthetiseren, maar zijn feitelijke assertions zijn gekoppeld aan opgehaalde bronnen in plaats van parametrisch geheugen.
- Live research pipelineEen productie-RAG-pipeline voor geautomatiseerd bloggen volgt vijf sequentiële fasen. Elke fase voegt latentie toe maar verbetert de uitvoerkwaliteit.
This latency is prohibitive for interactive chatbots but manageable for automated blogging. Production pipelines decouple generation from user requests using asynchronous job queues such as Celery or BullMQ. Articles generate in the background and publish on schedule.
Source Attribution and Trust Signals
Live-onderzochte content bevat inline-verwijzingen naar primaire bronnen. Hierdoor kunnen lezers claims verifiëren en zien zoekmachines dat de content onderbouwd is.
Domeinautoriteit speelt een rol bij de selectie van bronnen. Een pipeline die gegevens ophaalt van .gov-domeinen, gevestigde nieuwsorganisaties en peer-reviewed tijdschriften levert betrouwbaardere output dan een scraper die ongemodereerde forums doorzoekt. Productiesystemen filteren op domeinreputatie en sluiten bekende bronnen met lage geloofwaardigheid uit.
Het verschil tussen statische en live-onderzochte output is groot:
| Dimensie | Statische LLM-output | Live-onderzochte RAG-output |
|---|---|---|
| Feitelijke actualiteit | Bevroren op trainingsafkapmoment | Actueel op moment van generatie |
| Hallucinatieratio (FActScore) | 37–47% | Onder 10% |
| Verifieerbaarheid van bronnen | Geen | Inline-verwijzingen naar opgehaalde pagina's |
| SEO-risicoprofiel | Hoog: niet-originair, mogelijk onjuist | Lager: onderbouwd, actueel |
| Vertrouwenssignalen voor lezers | Generieke, ongeloofde claims | Specifieke, toegeschreven feiten |
SEO-prestaties en Googles standpunt over geautomatiseerde content
Google verbiedt geen AI-gegenereerde content. Het verbiedt laagwaardige, manipulatieve content, ongeacht de productiemethode. Googles officiële richtlijnen stellen: "Kwalitatieve content belonen, hoe deze ook wordt geproduceerd, is al jaren kern van Search."
De core update van Google in maart 2024 heeft echter de inzet verhoogd. Het bedrijf schafte zijn standalone Helpful Content System-classifier af en nam behulpzaamheidssignalen op in de core-rankingalgoritmen. Ook introduceerde het de spambeleid 'Scaled Content Abuse', gedefinieerd als het genereren van veel pagina's primair om zoekresultaten te manipuleren zonder waarde toe te voegen voor gebruikers.
Schaalbare contentmisbruik treedt op wanneer veel pagina's worden gegenereerd met het primaire doel zoekresultaten te manipuleren en gebruikers niet te helpen. Deze misbruikpraktijk richt zich doorgaans op het creëren van grote hoeveelheden niet-originale content die weinig tot geen waarde biedt aan gebruikers, ongeacht hoe deze wordt gemaakt.
Google Search Central Documentatie, Officiële Web Search Spam Policies
De update van maart 2024 leverde meetbare resultaten op: Google bevestigde een reductie van 45% in laagwaardige, niet-originale content in zoekresultaten na voltooiing van de uitrol.
Live webonderzoek speelt direct in op de kwaliteitssignalen van Google. Verse, toegeschreven content toont Experience, Expertise, Authoritativeness en Trustworthiness (E-E-A-T). Nauwkeurige antwoorden verminderen de bounce rate omdat lezers vinden waar ze naar zochten, in plaats van tegen verouderde informatie aanlopen.
Implementatievalkuilen en hoe je ermee omgaat
Live onderzoek betekent niet automatisch kwaliteit. Slechte implementatie introduceert nieuwe faalmodi.
Betaalmuur en beperkte content
Retrieval-systemen komen vaak tegen betaalmuren van nieuwsartikelen of afgeschermde wetenschappelijke papers. De kop kan worden opgehaald, maar de volledige feitelijke context is ontoegankelijk. Productiepipelines moeten betaalmuursymbolen detecteren en deze bronnen uitsluiten of markeren voor menselijke review, in plaats van te synthetiseren vanuit onvolledige informatie.
Tegenstrijdige bronnen
Live zoeken kan contradictorische claims opleveren van even geloofwaardige bronnen. Robuuste systemen moeten hiermee omgaan door nuance toe te voegen of beide perspectieven weer te geven, in plaats van willekeurig één claim te kiezen.
Low-Quality Scraper Contamination
Search results include content farms and auto-generated summaries lacking original reporting. Without filtering, a RAG pipeline can ingest and regurgitate this material. Domain allowlists, content freshness weighting, and semantic deduplication help exclude noise.
Copyright and Fair Use Boundaries
Live scraping raises legal considerations. Retrieval systems download and temporarily store copyrighted web content for analysis. Fair use generally protects intermediate copying for transformative purposes like summarization, but wholesale reproduction infringes copyright. Automated blogging pipelines should:
- Limit direct quotation to brief, attributed excerpts
- Transform retrieved information through original synthesis and structure
- Verwijzen naar bronnen in plaats van ze te vervangen
- Respecteer robots.txt en servicevoorwaarden op doelsites
De meerwaarde van live-onderzoek zit in verificatie en actualiteit. Systemen die geschraapte tekst zonder transformatie opnieuw publiceren, schenden zowel het spambeleid van Google als het auteursrecht.
Beoordelen of je setup live-onderzoek nodig heeft
Niet elk blogartikel vereist real-time ophalen. Evergreen how-to-content over vaste onderwerpen kan prima worden bediend door goed samengestelde statische kennisbanken. Live-onderzoek wordt echter essentieel wanneer content betrekking heeft op:
- Tijdsgevoelig nieuws en trendanalyse
- Financiële gegevens, prijzen en marktomstandigheden
- Regelgeving en juridische vereisten
- Productreviews en specificaties
- Concurrentie-informatie en branchebenchmarks
- Evenementverslaggeving en geplande aankondigingen
Als je geautomatiseerde blog in deze domeinen opereert en momenteel genereert zonder live grounding, nadert je foutpercentage waarschijnlijk de 37–47% baseline zoals gedocumenteerd in LLM hallucination research. De verbetering van 73% tot 86% door RAG-integratie vertegenwoordigt een directe kwaliteitsupgrade die lezers en zoekmachines zullen detecteren.
Wat je moet controleren voordat je volgende geautomatiseerde post live gaat
- Is elk statistisch cijfer, elke datum en elke eigennaam terug te leiden naar een opgehaalde bron met een werkende URL?
- Komen bronnen van geloofwaardige domeinen in plaats van ongeverifieerde forums of content farms?
- Voegt het artikel originele structuur en synthese toe, of herschikt het slechts geschraapte zinnen?
- Heb je gecontroleerd dat er geen betaalmurenbronnen zijn geciteerd zonder toegankelijk bewijs?
- Is de informatie actueel op het moment van generatie, of is er mogelijk veroudering binnengeslopen door de trainingsafkapdatum?
Geautomatiseerd bloggen op schaal vraagt om meer dan vloeiende tekstgeneratie. Het vraagt om een verificatielaag die elke claim koppelt aan het live web. Als je platforms evalueert, vergelijk plannen die live-onderzoeksinfrastructuur bevatten met die welke alleen vertrouwen op statische modeluitvoer. Voor teams die klaar zijn voor implementatie, begin nu met een systeem dat generatie op basis van real-time data grondt vanaf het eerste artikel.
Lees verder
Meer over Blogautomatisering
- Blog AutomationOct 4, 2026
Web Integration for Blog Automation: How to Choose the Right Tools
Web integration for blog automation connects content generation pipelines to CMS platforms through APIs and middleware, eliminating manual copy-pasting and enabling scalable publishing workflows.
Lees artikel - PublicatieworkflowsOct 4, 2026
Live webonderzoek automatiseren voor AI-schrijfpijplines
Leer hoe je een pijplijn voor live webonderzoek bouwt die realtime zoek-API's koppelt aan LLM-schrijfsystemen. Met concrete stappen voor data-extractie, bronverificatie, geautomatiseerde bronvermelding en validatie vóór publicatie.
Lees artikel - WordPressOct 4, 2026
Geautomatiseerde WordPress-contentpijplijnen: Integratie en workflow
Geautomatiseerde contentcreatie in WordPress maakt gebruik van de REST API om AI-onderzochte, geoptimaliseerde artikelen rechtstreeks op je site te publiceren. Hierdoor verschuift de rol van blogger van schrijver naar redactionele strateeg die toezicht houdt op prompts, feiten en kwaliteitscontroles.
Lees artikel