 scale(0.100000,-0.100000)%22%3E%3Cpath d=%22M4297 11020 c-251 -23 -537 -106 -727 -212 -443 -246 -736 -645 -826 -1123 -18 -97 -19 -207 -19 -3245 0 -3437 -4 -3204 61 -3464 145 -585 533 -1052 1103 -1330 52 -25 105 -46 118 -46 39 0 90 26 110 56 17 27 18 80 24 959 5 900 6 934 28 1060 53 314 144 569 297 832 219 376 589 741 999 983 50 29 119 70 155 91 177 104 553 265 830 353 495 159 1130 272 1651 293 l156 6 -3 -229 c-7 -645 -130 -1193 -376 -1677 -155 -306 -373 -585 -598 -766 -329 -265 -571 -377 -1169 -542 -500 -137 -709 -225 -974 -409 -116 -80 -331 -295 -415 -415 -113 -160 -204 -370 -238 -552 -15 -79 -14 -89 1 -129 10 -28 28 -51 49 -64 33 -20 41 -20 1478 -20 1442 0 1599 3 1808 36 677 106 1325 449 1770 938 130 141 202 234 296 376 549 834 695 1868 404 2865 -103 350 -280 710 -483 980 -361 479 -868 808 -1442 935 -328 73 -460 80 -1577 80 l-908 0 0 1108 c0 1199 0 1198 -55 1387 -76 262 -240 486 -464 636 -134 90 -197 122 -340 169 -216 72 -482 102 -724 80z%22/%3E%3Cpath d=%22M6314 10340 c-26 -10 -72 -65 -79 -93 -3 -12 -4 -400 -3 -862 l3 -840 28 -79 c78 -222 264 -396 497 -467 l75 -23 867 -4 c958 -3 918 -6 958 60 11 18 20 45 20 60 0 60 79 -22 -1100 1143 -927 916 -1090 1075 -1122 1095 -34 21 -105 26 -144 10z%22/%3E%3C/g%3E%3C/g%3E%3Cpath fill=%22%230B1220%22 d=%22M1436.7552 845.272V779.8000000000001H1547.4624000000001Q1577.2224 779.8000000000001 1592.4 763.432Q1607.5776 747.0640000000001 1607.5776 717.8992000000001Q1607.5776 688.1392000000001 1591.2096000000001 670.8784Q1574.8416 653.6176 1544.4864 653.6176H1436.7552V588.1456000000001H1539.7248Q1567.6992 588.1456000000001 1582.2816 574.7536Q1596.864 561.3616 1596.864 535.1728Q1596.864 508.98400000000004 1582.8768 495.592Q1568.8896 482.2 1541.5104000000001 482.2H1436.7552V416.728H1561.152Q1618.2912000000001 416.728 1653.4080000000001 445.8928Q1688.5248000000001 475.05760000000004 1688.5248000000001 525.0544Q1688.5248000000001 556.6 1673.6448 579.2176Q1658.7648 601.8352 1633.7664 613.7392Q1608.768 625.6432 1577.8176 625.6432L1580.7936 613.144Q1614.1248 613.144 1641.2064 627.4288Q1668.288 641.7136 1684.3584 667.6048000000001Q1700.4288000000001 693.4960000000001 1700.4288000000001 728.6128Q1700.4288000000001 763.7296 1684.0608000000002 790.216Q1667.6928 816.7024 1638.2304 830.9872Q1608.768 845.272 1568.8896 845.272ZM1361.76 845.272V416.728H1453.4208V845.272Z M1742.0928 845.272V416.728H1831.3727999999999V845.272Z M2034.9312 851.224Q1984.9343999999999 851.224 1947.1391999999998 831.2848000000001Q1909.3439999999998 811.3456000000001 1888.2143999999998 775.336Q1867.0847999999999 739.3264 1867.0847999999999 692.3056Q1867.0847999999999 645.2848 1888.2143999999998 610.168Q1909.3439999999998 575.0512 1947.1391999999998 555.4096Q1984.9343999999999 535.768 2034.9312 535.768Q2085.5232 535.768 2123.3184 555.4096Q2161.1135999999997 575.0512 2181.9456 610.168Q2202.7776 645.2848 2202.7776 692.3056Q2202.7776 739.3264 2181.648 775.336Q2160.5184 811.3456000000001 2122.7232 831.2848000000001Q2084.928 851.224 2034.9312 851.224ZM2034.9312 780.9904Q2055.7632 780.9904 2072.7263999999996 770.2768000000001Q2089.6895999999997 759.5632 2099.808 739.624Q2109.9264 719.6848 2109.9264 691.7104Q2109.9264 650.6416 2088.2016 628.3216Q2066.4768 606.0016 2034.9312 606.0016Q2003.3855999999998 606.0016 1981.6607999999999 628.6192000000001Q1959.936 651.2368 1959.936 691.7104Q1959.936 719.6848 1970.0544 739.624Q1980.1727999999998 759.5632 1997.136 770.2768000000001Q2014.0991999999999 780.9904 2034.9312 780.9904Z M2378.3615999999997 973.24Q2315.2704 973.24 2275.6895999999997 946.456Q2236.1088 919.672 2228.9664 873.8416000000001H2313.4847999999997Q2318.2464 885.1504000000001 2334.0191999999997 891.1024000000001Q2349.792 897.0544000000001 2374.1952 897.0544000000001Q2414.6688 897.0544000000001 2433.12 881.5792000000001Q2451.5712 866.104 2451.5712 833.368V767.3008L2456.3328 768.4912Q2450.3808 801.8224 2421.8112 821.1664000000001Q2393.2416 840.5104 2350.9824 840.5104Q2310.5088 840.5104 2280.4512 821.7616Q2250.3936 803.0128000000001 2233.728 769.0864000000001Q2217.0624 735.1600000000001 2217.0624 689.3296Q2217.0624 642.904 2234.3232 608.3824Q2251.584 573.8608 2282.832 554.8144Q2314.08 535.768 2355.7439999999997 535.768Q2398.5984 535.768 2425.68 556.0048Q2452.7616 576.2416000000001 2457.5232 611.3584000000001L2453.3568 611.9536V541.72H2540.8512V832.1776000000001Q2540.8512 897.6496000000001 2497.4016 935.4448Q2453.9519999999998 973.24 2378.3615999999997 973.24ZM2381.9328 772.0624Q2413.4784 772.0624 2433.12 750.3376000000001Q2452.7616 728.6128 2452.7616 688.1392000000001Q2452.7616 647.6656 2432.8224 625.9408000000001Q2412.8831999999998 604.216 2380.7424 604.216Q2349.792 604.216 2329.8527999999997 626.2384Q2309.9136 648.2608 2309.9136 688.7344Q2309.9136 729.2080000000001 2329.8527999999997 750.6352Q2349.792 772.0624 2381.9328 772.0624Z%22/%3E%3Cpath fill=%22%231F63F5%22 d=%22M2718.8160000000003 845.272V486.96160000000003H2578.944V416.728H2950.3488V486.96160000000003H2810.4768V845.272Z M3131.2896 851.224Q3080.6976 851.224 3043.2 831.2848000000001Q3005.7024 811.3456000000001 2985.168 775.6336000000001Q2964.6336 739.9216 2964.6336 693.4960000000001Q2964.6336 646.4752000000001 2985.168 611.0608000000001Q3005.7024 575.6464000000001 3042.6048 555.7072000000001Q3079.5072 535.768 3128.3136 535.768Q3175.3344 535.768 3209.856 554.8144Q3244.3776000000003 573.8608 3263.424 607.7872Q3282.4704 641.7136 3282.4704 687.5440000000001Q3282.4704 697.0672000000001 3281.8752000000004 705.1024Q3281.28 713.1376 3280.0896000000002 720.28H3017.0112V661.3552H3208.0704L3192.5952 672.0688Q3192.5952 635.1664000000001 3175.0368 617.6080000000001Q3157.4784 600.0496 3127.1232 600.0496Q3092.0064 600.0496 3072.6624 623.8576Q3053.3184 647.6656 3053.3184 695.2816Q3053.3184 741.7072000000001 3072.6624 764.3248000000001Q3092.0064 786.9424 3130.6944000000003 786.9424Q3152.1216 786.9424 3167.5968000000003 779.8Q3183.072 772.6576 3190.8096 756.5872H3274.7328Q3259.8528 800.6320000000001 3223.8432000000003 825.9280000000001Q3187.8336 851.224 3131.2896 851.224Z M3318.1824 845.272V541.72H3405.6768V613.144H3407.4624000000003V845.272ZM3529.4784 845.272V657.1888Q3529.4784 632.1904000000001 3516.6816 619.6912Q3503.8848000000003 607.192 3479.4816 607.192Q3458.6496 607.192 3442.2816000000003 616.7152Q3425.9136000000003 626.2384 3416.688 642.904Q3407.4624000000003 659.5696 3407.4624000000003 682.1872000000001L3399.7248 608.9776Q3414.6048 575.6464000000001 3443.472 555.7072000000001Q3472.3392000000003 535.768 3514.5984000000003 535.768Q3565.1904000000004 535.768 3591.9744 564.04Q3618.7584 592.312 3618.7584 639.928V845.272Z M3889.5744000000004 845.272V778.0144L3895.5264 779.2048Q3889.5744000000004 811.9408000000001 3860.112 831.5824Q3830.6496 851.224 3789.5808 851.224Q3747.9168000000004 851.224 3717.264 831.8800000000001Q3686.6112000000003 812.5360000000001 3669.9456 777.4192Q3653.28 742.3024 3653.28 694.6864Q3653.28 646.4752000000001 3670.5408 610.7632000000001Q3687.8016000000002 575.0512 3719.0496000000003 555.4096Q3750.2976000000003 535.768 3791.9616000000005 535.768Q3835.4112000000005 535.768 3862.4928000000004 556.0048Q3889.5744000000004 576.2416000000001 3894.3360000000002 611.3584000000001L3887.7888000000003 611.9536V416.728H3977.0688000000005V845.272ZM3818.1504000000004 779.8000000000001Q3849.6960000000004 779.8000000000001 3869.3376000000003 757.48Q3888.9792 735.1600000000001 3888.9792 693.4960000000001Q3888.9792 651.832 3869.04 629.512Q3849.1008 607.192 3816.9600000000005 607.192Q3786.0096000000003 607.192 3766.0704000000005 629.8096Q3746.1312000000003 652.4272000000001 3746.1312000000003 694.0912000000001Q3746.1312000000003 735.7552000000001 3766.0704000000005 757.7776000000001Q3786.0096000000003 779.8000000000001 3818.1504000000004 779.8000000000001Z%22/%3E%3C/svg%3E)
 scale(0.100000,-0.100000)%22%3E%3Cpath d=%22M4297 11020 c-251 -23 -537 -106 -727 -212 -443 -246 -736 -645 -826 -1123 -18 -97 -19 -207 -19 -3245 0 -3437 -4 -3204 61 -3464 145 -585 533 -1052 1103 -1330 52 -25 105 -46 118 -46 39 0 90 26 110 56 17 27 18 80 24 959 5 900 6 934 28 1060 53 314 144 569 297 832 219 376 589 741 999 983 50 29 119 70 155 91 177 104 553 265 830 353 495 159 1130 272 1651 293 l156 6 -3 -229 c-7 -645 -130 -1193 -376 -1677 -155 -306 -373 -585 -598 -766 -329 -265 -571 -377 -1169 -542 -500 -137 -709 -225 -974 -409 -116 -80 -331 -295 -415 -415 -113 -160 -204 -370 -238 -552 -15 -79 -14 -89 1 -129 10 -28 28 -51 49 -64 33 -20 41 -20 1478 -20 1442 0 1599 3 1808 36 677 106 1325 449 1770 938 130 141 202 234 296 376 549 834 695 1868 404 2865 -103 350 -280 710 -483 980 -361 479 -868 808 -1442 935 -328 73 -460 80 -1577 80 l-908 0 0 1108 c0 1199 0 1198 -55 1387 -76 262 -240 486 -464 636 -134 90 -197 122 -340 169 -216 72 -482 102 -724 80z%22/%3E%3Cpath d=%22M6314 10340 c-26 -10 -72 -65 -79 -93 -3 -12 -4 -400 -3 -862 l3 -840 28 -79 c78 -222 264 -396 497 -467 l75 -23 867 -4 c958 -3 918 -6 958 60 11 18 20 45 20 60 0 60 79 -22 -1100 1143 -927 916 -1090 1075 -1122 1095 -34 21 -105 26 -144 10z%22/%3E%3C/g%3E%3C/g%3E%3Cpath fill=%22%23FFFFFF%22 d=%22M1436.7552 845.272V779.8000000000001H1547.4624000000001Q1577.2224 779.8000000000001 1592.4 763.432Q1607.5776 747.0640000000001 1607.5776 717.8992000000001Q1607.5776 688.1392000000001 1591.2096000000001 670.8784Q1574.8416 653.6176 1544.4864 653.6176H1436.7552V588.1456000000001H1539.7248Q1567.6992 588.1456000000001 1582.2816 574.7536Q1596.864 561.3616 1596.864 535.1728Q1596.864 508.98400000000004 1582.8768 495.592Q1568.8896 482.2 1541.5104000000001 482.2H1436.7552V416.728H1561.152Q1618.2912000000001 416.728 1653.4080000000001 445.8928Q1688.5248000000001 475.05760000000004 1688.5248000000001 525.0544Q1688.5248000000001 556.6 1673.6448 579.2176Q1658.7648 601.8352 1633.7664 613.7392Q1608.768 625.6432 1577.8176 625.6432L1580.7936 613.144Q1614.1248 613.144 1641.2064 627.4288Q1668.288 641.7136 1684.3584 667.6048000000001Q1700.4288000000001 693.4960000000001 1700.4288000000001 728.6128Q1700.4288000000001 763.7296 1684.0608000000002 790.216Q1667.6928 816.7024 1638.2304 830.9872Q1608.768 845.272 1568.8896 845.272ZM1361.76 845.272V416.728H1453.4208V845.272Z M1742.0928 845.272V416.728H1831.3727999999999V845.272Z M2034.9312 851.224Q1984.9343999999999 851.224 1947.1391999999998 831.2848000000001Q1909.3439999999998 811.3456000000001 1888.2143999999998 775.336Q1867.0847999999999 739.3264 1867.0847999999999 692.3056Q1867.0847999999999 645.2848 1888.2143999999998 610.168Q1909.3439999999998 575.0512 1947.1391999999998 555.4096Q1984.9343999999999 535.768 2034.9312 535.768Q2085.5232 535.768 2123.3184 555.4096Q2161.1135999999997 575.0512 2181.9456 610.168Q2202.7776 645.2848 2202.7776 692.3056Q2202.7776 739.3264 2181.648 775.336Q2160.5184 811.3456000000001 2122.7232 831.2848000000001Q2084.928 851.224 2034.9312 851.224ZM2034.9312 780.9904Q2055.7632 780.9904 2072.7263999999996 770.2768000000001Q2089.6895999999997 759.5632 2099.808 739.624Q2109.9264 719.6848 2109.9264 691.7104Q2109.9264 650.6416 2088.2016 628.3216Q2066.4768 606.0016 2034.9312 606.0016Q2003.3855999999998 606.0016 1981.6607999999999 628.6192000000001Q1959.936 651.2368 1959.936 691.7104Q1959.936 719.6848 1970.0544 739.624Q1980.1727999999998 759.5632 1997.136 770.2768000000001Q2014.0991999999999 780.9904 2034.9312 780.9904Z M2378.3615999999997 973.24Q2315.2704 973.24 2275.6895999999997 946.456Q2236.1088 919.672 2228.9664 873.8416000000001H2313.4847999999997Q2318.2464 885.1504000000001 2334.0191999999997 891.1024000000001Q2349.792 897.0544000000001 2374.1952 897.0544000000001Q2414.6688 897.0544000000001 2433.12 881.5792000000001Q2451.5712 866.104 2451.5712 833.368V767.3008L2456.3328 768.4912Q2450.3808 801.8224 2421.8112 821.1664000000001Q2393.2416 840.5104 2350.9824 840.5104Q2310.5088 840.5104 2280.4512 821.7616Q2250.3936 803.0128000000001 2233.728 769.0864000000001Q2217.0624 735.1600000000001 2217.0624 689.3296Q2217.0624 642.904 2234.3232 608.3824Q2251.584 573.8608 2282.832 554.8144Q2314.08 535.768 2355.7439999999997 535.768Q2398.5984 535.768 2425.68 556.0048Q2452.7616 576.2416000000001 2457.5232 611.3584000000001L2453.3568 611.9536V541.72H2540.8512V832.1776000000001Q2540.8512 897.6496000000001 2497.4016 935.4448Q2453.9519999999998 973.24 2378.3615999999997 973.24ZM2381.9328 772.0624Q2413.4784 772.0624 2433.12 750.3376000000001Q2452.7616 728.6128 2452.7616 688.1392000000001Q2452.7616 647.6656 2432.8224 625.9408000000001Q2412.8831999999998 604.216 2380.7424 604.216Q2349.792 604.216 2329.8527999999997 626.2384Q2309.9136 648.2608 2309.9136 688.7344Q2309.9136 729.2080000000001 2329.8527999999997 750.6352Q2349.792 772.0624 2381.9328 772.0624Z%22/%3E%3Cpath fill=%22%235B93FF%22 d=%22M2718.8160000000003 845.272V486.96160000000003H2578.944V416.728H2950.3488V486.96160000000003H2810.4768V845.272Z M3131.2896 851.224Q3080.6976 851.224 3043.2 831.2848000000001Q3005.7024 811.3456000000001 2985.168 775.6336000000001Q2964.6336 739.9216 2964.6336 693.4960000000001Q2964.6336 646.4752000000001 2985.168 611.0608000000001Q3005.7024 575.6464000000001 3042.6048 555.7072000000001Q3079.5072 535.768 3128.3136 535.768Q3175.3344 535.768 3209.856 554.8144Q3244.3776000000003 573.8608 3263.424 607.7872Q3282.4704 641.7136 3282.4704 687.5440000000001Q3282.4704 697.0672000000001 3281.8752000000004 705.1024Q3281.28 713.1376 3280.0896000000002 720.28H3017.0112V661.3552H3208.0704L3192.5952 672.0688Q3192.5952 635.1664000000001 3175.0368 617.6080000000001Q3157.4784 600.0496 3127.1232 600.0496Q3092.0064 600.0496 3072.6624 623.8576Q3053.3184 647.6656 3053.3184 695.2816Q3053.3184 741.7072000000001 3072.6624 764.3248000000001Q3092.0064 786.9424 3130.6944000000003 786.9424Q3152.1216 786.9424 3167.5968000000003 779.8Q3183.072 772.6576 3190.8096 756.5872H3274.7328Q3259.8528 800.6320000000001 3223.8432000000003 825.9280000000001Q3187.8336 851.224 3131.2896 851.224Z M3318.1824 845.272V541.72H3405.6768V613.144H3407.4624000000003V845.272ZM3529.4784 845.272V657.1888Q3529.4784 632.1904000000001 3516.6816 619.6912Q3503.8848000000003 607.192 3479.4816 607.192Q3458.6496 607.192 3442.2816000000003 616.7152Q3425.9136000000003 626.2384 3416.688 642.904Q3407.4624000000003 659.5696 3407.4624000000003 682.1872000000001L3399.7248 608.9776Q3414.6048 575.6464000000001 3443.472 555.7072000000001Q3472.3392000000003 535.768 3514.5984000000003 535.768Q3565.1904000000004 535.768 3591.9744 564.04Q3618.7584 592.312 3618.7584 639.928V845.272Z M3889.5744000000004 845.272V778.0144L3895.5264 779.2048Q3889.5744000000004 811.9408000000001 3860.112 831.5824Q3830.6496 851.224 3789.5808 851.224Q3747.9168000000004 851.224 3717.264 831.8800000000001Q3686.6112000000003 812.5360000000001 3669.9456 777.4192Q3653.28 742.3024 3653.28 694.6864Q3653.28 646.4752000000001 3670.5408 610.7632000000001Q3687.8016000000002 575.0512 3719.0496000000003 555.4096Q3750.2976000000003 535.768 3791.9616000000005 535.768Q3835.4112000000005 535.768 3862.4928000000004 556.0048Q3889.5744000000004 576.2416000000001 3894.3360000000002 611.3584000000001L3887.7888000000003 611.9536V416.728H3977.0688000000005V845.272ZM3818.1504000000004 779.8000000000001Q3849.6960000000004 779.8000000000001 3869.3376000000003 757.48Q3888.9792 735.1600000000001 3888.9792 693.4960000000001Q3888.9792 651.832 3869.04 629.512Q3849.1008 607.192 3816.9600000000005 607.192Q3786.0096000000003 607.192 3766.0704000000005 629.8096Q3746.1312000000003 652.4272000000001 3746.1312000000003 694.0912000000001Q3746.1312000000003 735.7552000000001 3766.0704000000005 757.7776000000001Q3786.0096000000003 779.8000000000001 3818.1504000000004 779.8000000000001Z%22/%3E%3C/svg%3E)
Comment la recherche web en temps réel garantit l'exactitude du contenu dans le blogging automatisé
Les systèmes de blogging automatisés utilisant la recherche web en temps réel réduisent les taux d'hallucination de 73 % à 86 % grâce à la récupération de données en direct. Cet article explique comment fonctionne la génération augmentée par récupération et pourquoi elle est importante pour le SEO.
Les systèmes de blogging automatisés reposant uniquement sur des grands modèles de langage pré-entraînés produisent fréquemment des erreurs factuelles et des affirmations obsolètes. La recherche web en direct pour le blogging automatisé, fondée sur des architectures de génération augmentée par récupération (RAG), réduit les taux d'hallucination de 73 % à 86 % en intégrant des données en temps réel au processus de génération plutôt qu'en dépendant de poids d'entraînement statiques.
Pourquoi le contenu automatisé standard échoue sur les faits
Les grands modèles de langage génèrent du texte en prédisant les tokens suivants probables basés sur des motifs d'entraînement. Cela crée une prose fluide mais ne garantit pas l'exactitude. Lorsqu'un modèle manque de connaissances paramétriques fiables pour une affirmation spécifique, il hallucine. Il fabrique des faits, des citations, des dates ou des statistiques qui semblent plausibles mais sont faux.
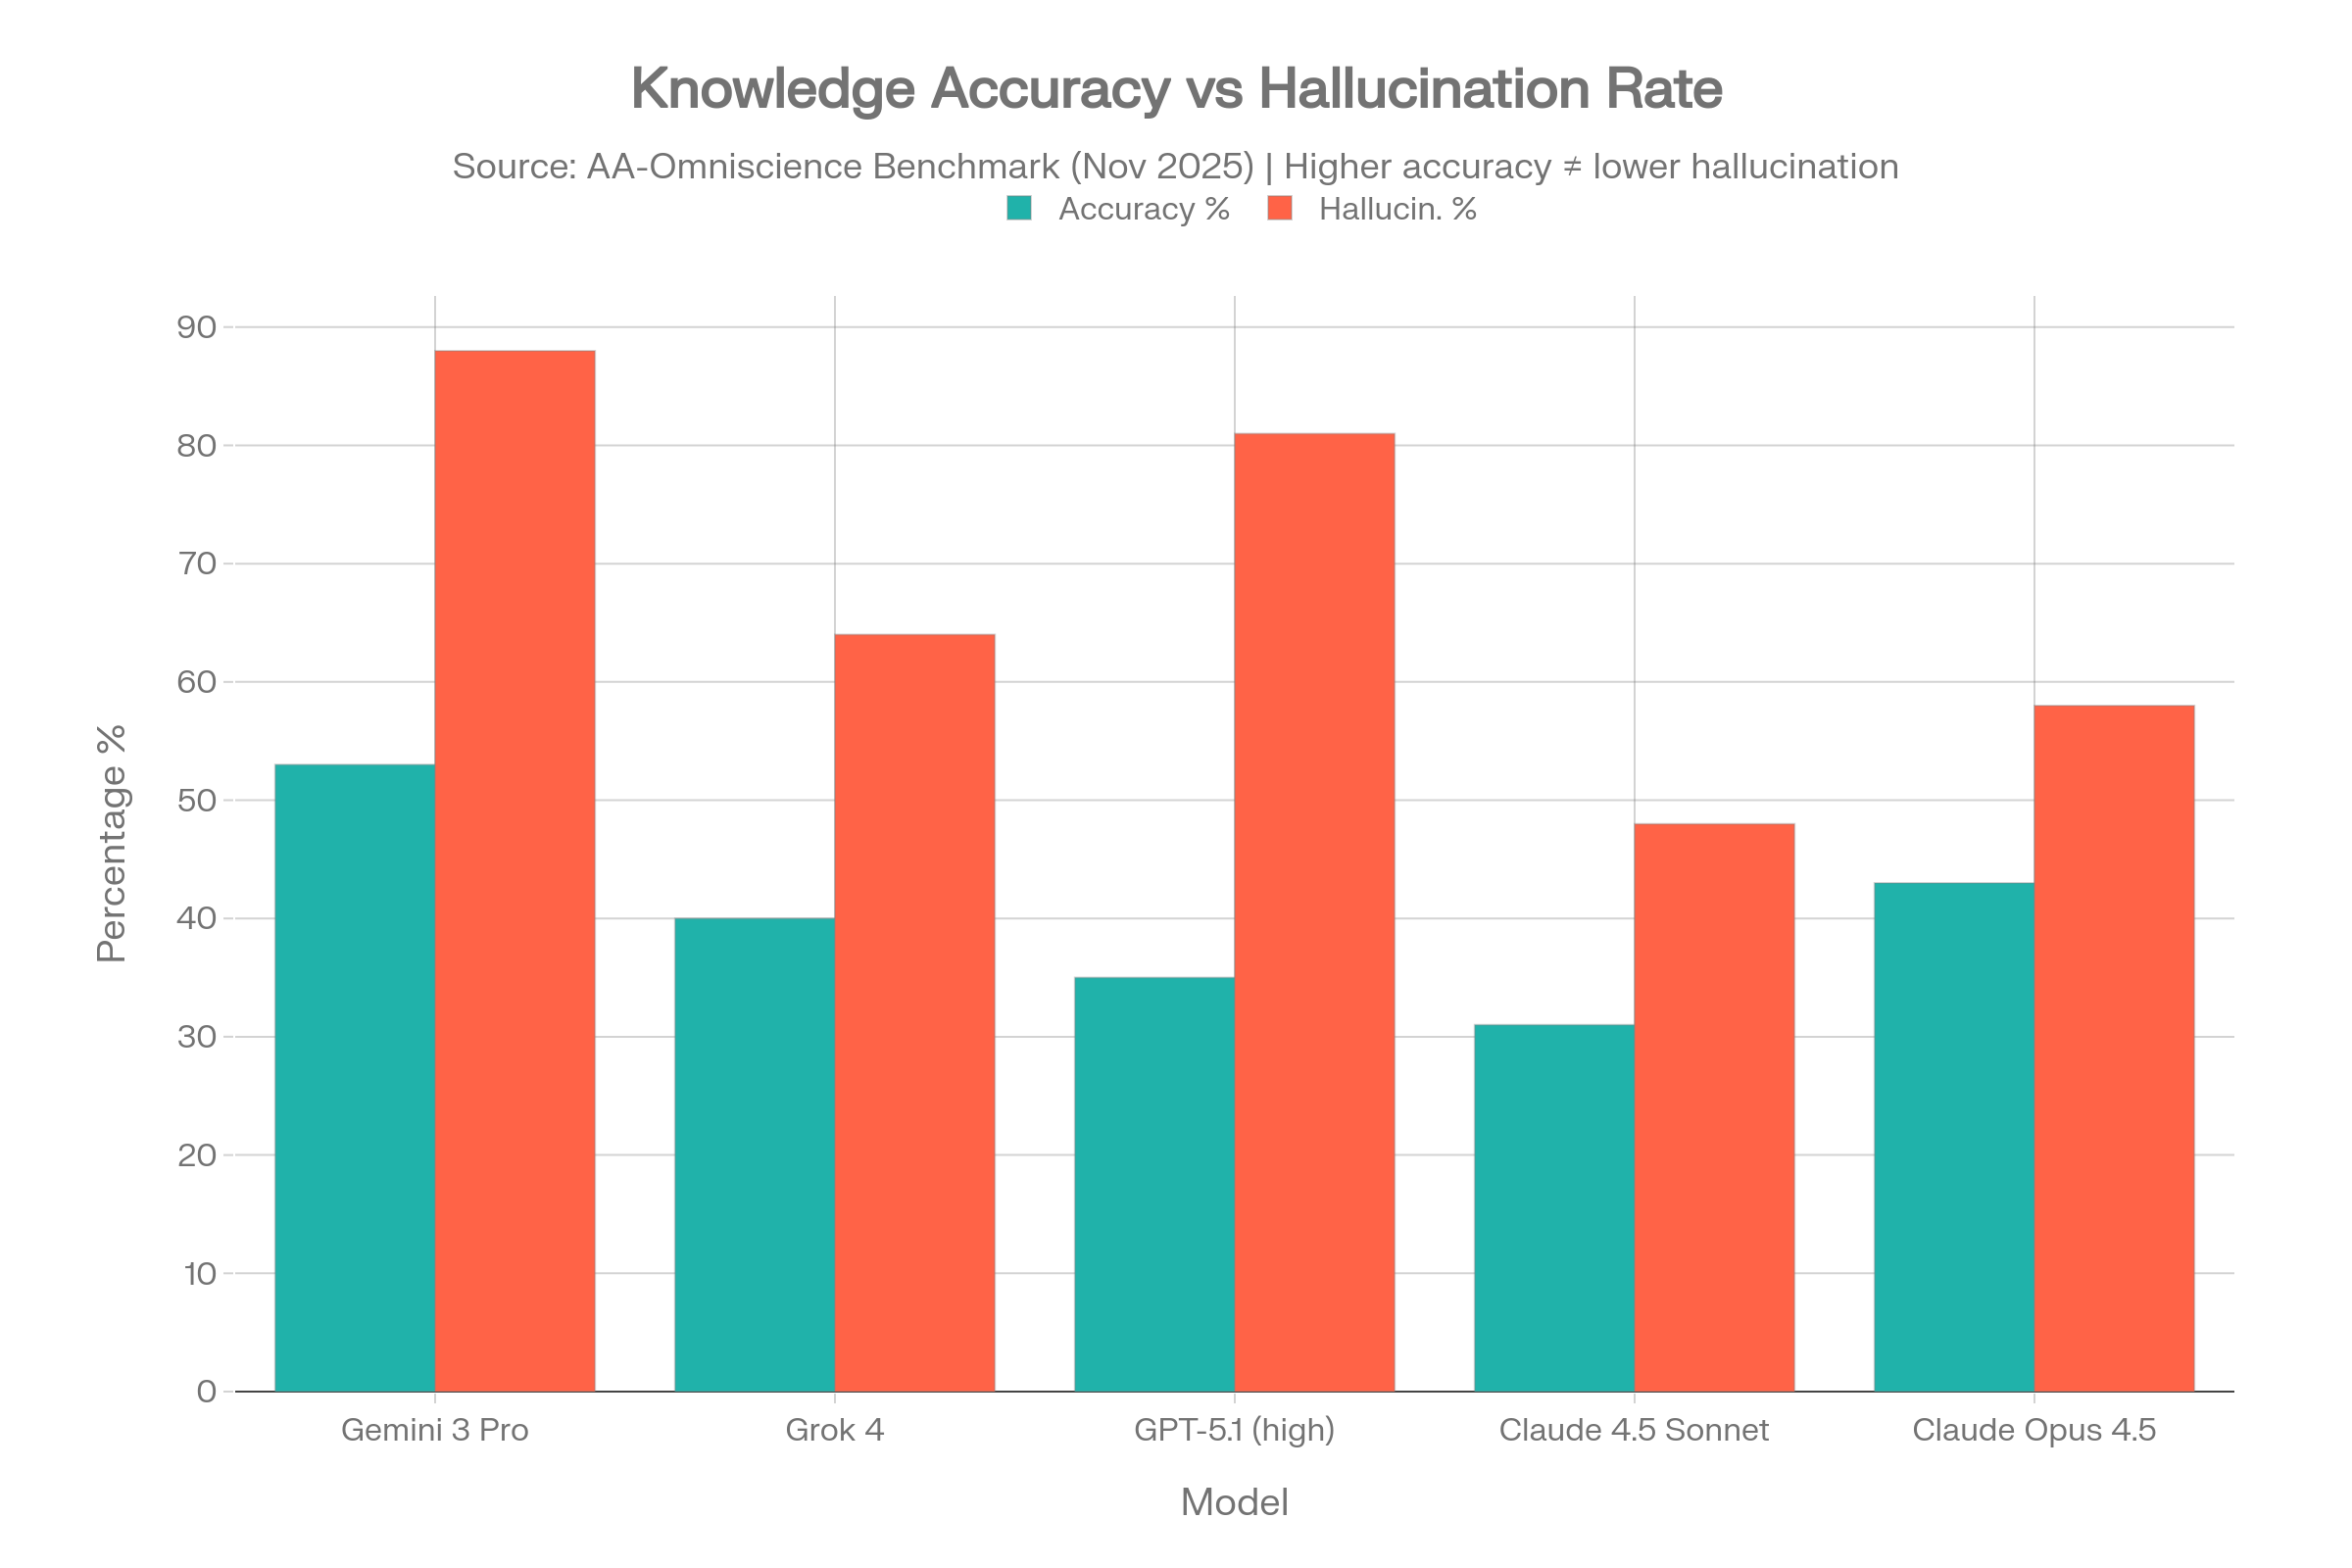
Sur des benchmarks à domaine ouvert comme FActScore et SimpleQA, les LLM non ancrés hallucinent à des taux compris entre 37 % et 47 % sur les tâches de long format, selon l'analyse de précision 2026 de Suprmind. Le problème s'aggrave dans les niches à évolution rapide où les données d'entraînement ne peuvent pas capturer les développements récents.
Les modèles statiques échouent régulièrement sur :
- Prix actuels, taux de change et données de marché
- Réglementations récemment promulguées ou changements de politique
- Actualités urgentes et tendances émergentes
- Spécifications produits et disponibilité
- Statistiques mises à jour issues de recherches en cours
Sans récupération de données en direct, un article de blog automatisé sur les « seuils de déclaration fiscale 2026 » propagera probablement des informations obsolètes. Les lecteurs le remarquent, la confiance s'érode et les moteurs de recherche pénalisent le contenu pauvre.
Ce que signifie la recherche web en direct pour le blogging automatisé
La recherche web en direct dans l'automatisation consiste à interroger des moteurs de recherche, des API et des bases de données structurées pendant la génération de contenu. Le système injecte ensuite les informations récupérées dans la fenêtre de contexte du modèle. Cette méthode repose sur une récupération en temps réel plutôt que sur le prétraitement d'une base de connaissances statique.
Cette technique est appelée Génération Augmentée par Récupération (RAG). Formalisée pour la première fois dans la recherche de Lewis et al. en 2020 sur les tâches NLP intensives en connaissances, la RAG sépare la capacité de raisonnement du modèle de langage de sa base de connaissances factuelle. Le modèle écrit ; le système de récupération fournit les faits.
Les piles technologiques modernes de blogging automatisé utilisent deux couches de récupération distinctes :
| Type de couche | Exemples | Format de sortie | Idéal pour |
|---|---|---|---|
| Récupération web native IA | Tavily, Exa, Linkup, Brave Search API | Markdown pré-nettoyé, résumés sémantiques | Injection directe dans le contexte LLM |
| Scrapers SERP traditionnels | SerpApi, Serper.dev, Firecrawl | Métadonnées SERP brutes, nécessitent une analyse HTML | Pipelines d'extraction personnalisés |
Microsoft a retiré l'API Bing Search autonome le 11 août 2025, accélérant la migration vers des alternatives natives IA. L'API Brave Search indexe plus de 40 milliards de pages indépendamment de Google ou Bing, offrant un corpus distinct pour la vérification.
Le pipeline de recherche en direct : De la requête au fait publié
Un pipeline RAG de production pour le blogging automatisé suit cinq étapes séquentielles. Chaque étape ajoute de la latence mais améliore la qualité de la sortie.
- Formulation de la requêteLe système analyse le brief de l'article et convertit les affirmations en requêtes de recherche spécifiques. « Discuter des taux d'imposition des plus-values 2026 » devient des requêtes ciblées pour les publications de l'IRS et le journalisme financier vérifié.
- Récupération des sourcesLes API de recherche renvoient des résultats classés. Les pipelines avancés exécutent plusieurs requêtes parallèles et appliquent un re-ranking par cross-encoder pour faire ressortir les passages les plus pertinents.
- Injection de contexteLe texte récupéré est découpé en chunks, dédupliqué et formaté pour la fenêtre de contexte du LLM. Les API natives IA comme Tavily renvoient du markdown pré-structuré optimisé pour cette étape.
- Génération ancréeLe modèle génère une prose contrainte par le contexte injecté. Il peut citer, paraphraser ou synthétiser, mais ses assertions factuelles sont rattachées aux sources récupérées plutôt qu'à la mémoire paramétrique.
- Pipeline de recherche en directLe modèle génère une prose contrainte par le contexte injecté. Il peut citer, paraphraser ou synthétiser, mais ses assertions factuelles sont rattachées aux sources récupérées plutôt qu'à la mémoire paramétrique.
This latency is prohibitive for interactive chatbots but manageable for automated blogging. Production pipelines decouple generation from user requests using asynchronous job queues such as Celery or BullMQ. Articles generate in the background and publish on schedule.
Source Attribution and Trust Signals
Le contenu généré après recherche en temps réel inclut des citations intégrées vers des sources primaires. Cela permet aux lecteurs de vérifier les affirmations et signale aux moteurs de recherche que le contenu est étayé.
L'autorité du domaine compte dans la sélection des sources. Un pipeline qui récupère des données sur des domaines .gov, des organisations de presse établies et des revues à comité de lecture produit des résultats plus fiables qu'un système qui scrape des forums non modérés. Les systèmes de production filtrent selon la réputation du domaine et excluent les sources connues pour leur faible crédibilité.
La différence entre une sortie statique et une sortie issue d'une recherche en temps réel est marquée :
| Dimension | Sortie LLM statique | Sortie RAG issue d'une recherche en temps réel |
|---|---|---|
| Fraîcheur des faits | Gelée à la date limite d'entraînement | À jour au moment de la génération |
| Taux d'hallucination (FActScore) | 37–47% | Inférieur à 10 % |
| Vérifiabilité des sources | Aucune | Citations intégrées vers les pages récupérées |
| Profil de risque SEO | Élevé : non original, potentiellement faux | Plus faible : étayé, frais |
| Signaux de confiance pour le lecteur | Affirmations génériques, sans ancrage | Faits spécifiques, attribués |
Performance SEO et position de Google sur le contenu automatisé
Google n'interdit pas le contenu généré par IA. Il interdit le contenu de mauvaise qualité et manipulateur, quel que soit son mode de production. Les directives officielles de Google indiquent : « Récompenser le contenu de qualité, quelle que soit sa méthode de production, est au cœur de la Recherche depuis de nombreuses années. »
Cependant, la mise à jour principale de Google en mars 2024 a relevé les enjeux. L'entreprise a retiré son classificateur autonome Helpful Content System et intégré les signaux d'utilité dans ses algorithmes de classement principaux. Elle a introduit la politique anti-spam « Scaled Content Abuse », définie comme la génération de nombreuses pages principalement pour manipuler les classements de recherche sans apporter de valeur aux utilisateurs.
L'abus de contenu à grande échelle consiste à générer de nombreuses pages dans le but principal de manipuler les classements de recherche plutôt que d'aider les utilisateurs. Cette pratique abusive se concentre généralement sur la création de grandes quantités de contenu non original offrant peu ou pas de valeur aux utilisateurs, quelle que soit la méthode de création.
Documentation Google Search Central, Politiques officielles anti-spam pour la recherche web
La mise à jour de mars 2024 a donné des résultats mesurables : Google a confirmé une réduction de 45 % du contenu de mauvaise qualité et non original apparaissant dans les résultats de recherche après la fin du déploiement.
La recherche web en temps réel répond directement aux signaux de qualité de Google. Un contenu frais et attribué démontre l'Expérience, l'Expertise, l'Autorité et la Fiabilité (E-E-A-T). Des réponses précises réduisent le taux de rebond car les lecteurs trouvent ce qu'ils cherchaient au lieu de tomber sur des informations obsolètes.
Pièges de mise en œuvre et comment les gérer
La recherche en temps réel ne garantit pas automatiquement la qualité. Une mauvaise mise en œuvre introduit de nouveaux modes de défaillance.
Contenu payant et restreint
Les systèmes de récupération rencontrent fréquemment des articles de presse payants ou des documents de recherche réservés. Le titre peut être récupéré, mais le contexte factuel complet reste inaccessible. Les pipelines de production doivent détecter les indicateurs de paywall et soit exclure ces sources, soit les signaler pour une revue humaine plutôt que de synthétiser à partir d'informations incomplètes.
Sources contradictoires
La recherche en direct peut renvoyer des affirmations contradictoires provenant de sources tout aussi crédibles. Des systèmes robustes doivent gérer ces conflits.
Low-Quality Scraper Contamination
Search results include content farms and auto-generated summaries lacking original reporting. Without filtering, a RAG pipeline can ingest and regurgitate this material. Domain allowlists, content freshness weighting, and semantic deduplication help exclude noise.
Copyright and Fair Use Boundaries
Live scraping raises legal considerations. Retrieval systems download and temporarily store copyrighted web content for analysis. Fair use generally protects intermediate copying for transformative purposes like summarization, but wholesale reproduction infringes copyright. Automated blogging pipelines should:
- Limit direct quotation to brief, attributed excerpts
- Transform retrieved information through original synthesis and structure
- Lier vers les sources plutôt que de les remplacer
- Respecter le fichier robots.txt et les conditions d'utilisation des sites cibles
La valeur ajoutée par la recherche en direct réside dans la vérification et la fraîcheur de l'information. Les systèmes qui se contentent de republier du texte extrait sans transformation violent à la fois les politiques anti-spam de Google et le droit d'auteur.
Évaluer si votre configuration nécessite une recherche en direct
Tous les articles de blog ne nécessitent pas une récupération en temps réel. Le contenu intemporel de type « comment faire » sur des sujets établis peut être correctement servi par des bases de connaissances statiques bien organisées. Cependant, la recherche en direct devient essentielle lorsque le contenu couvre :
- Les actualités sensibles au temps et l'analyse des tendances
- Les données financières, les prix et les conditions du marché
- La conformité réglementaire et les exigences légales
- Les avis produits et les spécifications techniques
- Le renseignement concurrentiel et les références sectorielles
- La couverture d'événements et les annonces programmées
Si votre blog automatisé opère dans ces domaines et génère actuellement du contenu sans ancrage en direct, votre taux d'erreurs factuelles s'approche probablement de la référence de 37–47 % documentée dans la recherche sur les hallucinations des LLM. L'amélioration de 73 % à 86 % apportée par l'intégration RAG représente une amélioration directe de la qualité que les lecteurs et les moteurs de recherche détecteront.
Points à vérifier avant la publication de votre prochain article automatisé
- Chaque statistique, date et nom propre est-il traçable jusqu'à une source récupérée avec une URL fonctionnelle ?
- Les sources proviennent-elles de domaines crédibles plutôt que de forums non vérifiés ou de fermes de contenu ?
- L'article ajoute-t-il une structure originale et une synthèse, ou se contente-t-il de réarranger des phrases extraites ?
- Avez-vous vérifié qu'aucune source payante n'a été citée sans preuve accessible ?
- L'information est-elle à jour au moment de la génération, ou une obsolescence due à la date limite d'entraînement a-t-elle pu s'infiltrer ?
La tenue de blog automatisée à grande échelle exige plus qu'une génération de texte fluide. Elle exige une couche de vérification qui relie chaque affirmation au web en direct. Si vous évaluez des plateformes, comparez les offres incluant une infrastructure de recherche en direct avec celles reposant uniquement sur la sortie statique du modèle. Pour les équipes prêtes à mettre en œuvre, démarrer avec un système qui ancre la génération dans des données en temps réel dès le premier article.
Continuez la lecture
Découvrez d’autres articles sur Automatisation du blog
- Blog AutomationOct 4, 2026
Web Integration for Blog Automation: How to Choose the Right Tools
Web integration for blog automation connects content generation pipelines to CMS platforms through APIs and middleware, eliminating manual copy-pasting and enabling scalable publishing workflows.
Lire l’article - Flux de travail de publicationOct 4, 2026
Comment mettre en place l'automatisation de la recherche web en direct pour les pipelines d'écriture IA
Apprenez à construire un pipeline de recherche web en temps réel qui connecte des API de recherche aux systèmes d'écriture LLM, avec des étapes spécifiques pour l'extraction de données, le sourcing fiable, l'attribution automatique et la validation avant publication.
Lire l’article - WordPressOct 4, 2026
Pipelines de contenu automatisés pour WordPress : Intégration et flux de travail
La création automatisée de contenu dans WordPress utilise l’API REST pour publier directement sur votre site des articles optimisés, rédigés grâce à la recherche par IA. Le blogueur passe ainsi du rôle de rédacteur à celui de stratège éditorial, supervisant les prompts, les faits et les contrôles qualité.
Lire l’article