 scale(0.100000,-0.100000)%22%3E%3Cpath d=%22M4297 11020 c-251 -23 -537 -106 -727 -212 -443 -246 -736 -645 -826 -1123 -18 -97 -19 -207 -19 -3245 0 -3437 -4 -3204 61 -3464 145 -585 533 -1052 1103 -1330 52 -25 105 -46 118 -46 39 0 90 26 110 56 17 27 18 80 24 959 5 900 6 934 28 1060 53 314 144 569 297 832 219 376 589 741 999 983 50 29 119 70 155 91 177 104 553 265 830 353 495 159 1130 272 1651 293 l156 6 -3 -229 c-7 -645 -130 -1193 -376 -1677 -155 -306 -373 -585 -598 -766 -329 -265 -571 -377 -1169 -542 -500 -137 -709 -225 -974 -409 -116 -80 -331 -295 -415 -415 -113 -160 -204 -370 -238 -552 -15 -79 -14 -89 1 -129 10 -28 28 -51 49 -64 33 -20 41 -20 1478 -20 1442 0 1599 3 1808 36 677 106 1325 449 1770 938 130 141 202 234 296 376 549 834 695 1868 404 2865 -103 350 -280 710 -483 980 -361 479 -868 808 -1442 935 -328 73 -460 80 -1577 80 l-908 0 0 1108 c0 1199 0 1198 -55 1387 -76 262 -240 486 -464 636 -134 90 -197 122 -340 169 -216 72 -482 102 -724 80z%22/%3E%3Cpath d=%22M6314 10340 c-26 -10 -72 -65 -79 -93 -3 -12 -4 -400 -3 -862 l3 -840 28 -79 c78 -222 264 -396 497 -467 l75 -23 867 -4 c958 -3 918 -6 958 60 11 18 20 45 20 60 0 60 79 -22 -1100 1143 -927 916 -1090 1075 -1122 1095 -34 21 -105 26 -144 10z%22/%3E%3C/g%3E%3C/g%3E%3Cpath fill=%22%230B1220%22 d=%22M1436.7552 845.272V779.8000000000001H1547.4624000000001Q1577.2224 779.8000000000001 1592.4 763.432Q1607.5776 747.0640000000001 1607.5776 717.8992000000001Q1607.5776 688.1392000000001 1591.2096000000001 670.8784Q1574.8416 653.6176 1544.4864 653.6176H1436.7552V588.1456000000001H1539.7248Q1567.6992 588.1456000000001 1582.2816 574.7536Q1596.864 561.3616 1596.864 535.1728Q1596.864 508.98400000000004 1582.8768 495.592Q1568.8896 482.2 1541.5104000000001 482.2H1436.7552V416.728H1561.152Q1618.2912000000001 416.728 1653.4080000000001 445.8928Q1688.5248000000001 475.05760000000004 1688.5248000000001 525.0544Q1688.5248000000001 556.6 1673.6448 579.2176Q1658.7648 601.8352 1633.7664 613.7392Q1608.768 625.6432 1577.8176 625.6432L1580.7936 613.144Q1614.1248 613.144 1641.2064 627.4288Q1668.288 641.7136 1684.3584 667.6048000000001Q1700.4288000000001 693.4960000000001 1700.4288000000001 728.6128Q1700.4288000000001 763.7296 1684.0608000000002 790.216Q1667.6928 816.7024 1638.2304 830.9872Q1608.768 845.272 1568.8896 845.272ZM1361.76 845.272V416.728H1453.4208V845.272Z M1742.0928 845.272V416.728H1831.3727999999999V845.272Z M2034.9312 851.224Q1984.9343999999999 851.224 1947.1391999999998 831.2848000000001Q1909.3439999999998 811.3456000000001 1888.2143999999998 775.336Q1867.0847999999999 739.3264 1867.0847999999999 692.3056Q1867.0847999999999 645.2848 1888.2143999999998 610.168Q1909.3439999999998 575.0512 1947.1391999999998 555.4096Q1984.9343999999999 535.768 2034.9312 535.768Q2085.5232 535.768 2123.3184 555.4096Q2161.1135999999997 575.0512 2181.9456 610.168Q2202.7776 645.2848 2202.7776 692.3056Q2202.7776 739.3264 2181.648 775.336Q2160.5184 811.3456000000001 2122.7232 831.2848000000001Q2084.928 851.224 2034.9312 851.224ZM2034.9312 780.9904Q2055.7632 780.9904 2072.7263999999996 770.2768000000001Q2089.6895999999997 759.5632 2099.808 739.624Q2109.9264 719.6848 2109.9264 691.7104Q2109.9264 650.6416 2088.2016 628.3216Q2066.4768 606.0016 2034.9312 606.0016Q2003.3855999999998 606.0016 1981.6607999999999 628.6192000000001Q1959.936 651.2368 1959.936 691.7104Q1959.936 719.6848 1970.0544 739.624Q1980.1727999999998 759.5632 1997.136 770.2768000000001Q2014.0991999999999 780.9904 2034.9312 780.9904Z M2378.3615999999997 973.24Q2315.2704 973.24 2275.6895999999997 946.456Q2236.1088 919.672 2228.9664 873.8416000000001H2313.4847999999997Q2318.2464 885.1504000000001 2334.0191999999997 891.1024000000001Q2349.792 897.0544000000001 2374.1952 897.0544000000001Q2414.6688 897.0544000000001 2433.12 881.5792000000001Q2451.5712 866.104 2451.5712 833.368V767.3008L2456.3328 768.4912Q2450.3808 801.8224 2421.8112 821.1664000000001Q2393.2416 840.5104 2350.9824 840.5104Q2310.5088 840.5104 2280.4512 821.7616Q2250.3936 803.0128000000001 2233.728 769.0864000000001Q2217.0624 735.1600000000001 2217.0624 689.3296Q2217.0624 642.904 2234.3232 608.3824Q2251.584 573.8608 2282.832 554.8144Q2314.08 535.768 2355.7439999999997 535.768Q2398.5984 535.768 2425.68 556.0048Q2452.7616 576.2416000000001 2457.5232 611.3584000000001L2453.3568 611.9536V541.72H2540.8512V832.1776000000001Q2540.8512 897.6496000000001 2497.4016 935.4448Q2453.9519999999998 973.24 2378.3615999999997 973.24ZM2381.9328 772.0624Q2413.4784 772.0624 2433.12 750.3376000000001Q2452.7616 728.6128 2452.7616 688.1392000000001Q2452.7616 647.6656 2432.8224 625.9408000000001Q2412.8831999999998 604.216 2380.7424 604.216Q2349.792 604.216 2329.8527999999997 626.2384Q2309.9136 648.2608 2309.9136 688.7344Q2309.9136 729.2080000000001 2329.8527999999997 750.6352Q2349.792 772.0624 2381.9328 772.0624Z%22/%3E%3Cpath fill=%22%231F63F5%22 d=%22M2718.8160000000003 845.272V486.96160000000003H2578.944V416.728H2950.3488V486.96160000000003H2810.4768V845.272Z M3131.2896 851.224Q3080.6976 851.224 3043.2 831.2848000000001Q3005.7024 811.3456000000001 2985.168 775.6336000000001Q2964.6336 739.9216 2964.6336 693.4960000000001Q2964.6336 646.4752000000001 2985.168 611.0608000000001Q3005.7024 575.6464000000001 3042.6048 555.7072000000001Q3079.5072 535.768 3128.3136 535.768Q3175.3344 535.768 3209.856 554.8144Q3244.3776000000003 573.8608 3263.424 607.7872Q3282.4704 641.7136 3282.4704 687.5440000000001Q3282.4704 697.0672000000001 3281.8752000000004 705.1024Q3281.28 713.1376 3280.0896000000002 720.28H3017.0112V661.3552H3208.0704L3192.5952 672.0688Q3192.5952 635.1664000000001 3175.0368 617.6080000000001Q3157.4784 600.0496 3127.1232 600.0496Q3092.0064 600.0496 3072.6624 623.8576Q3053.3184 647.6656 3053.3184 695.2816Q3053.3184 741.7072000000001 3072.6624 764.3248000000001Q3092.0064 786.9424 3130.6944000000003 786.9424Q3152.1216 786.9424 3167.5968000000003 779.8Q3183.072 772.6576 3190.8096 756.5872H3274.7328Q3259.8528 800.6320000000001 3223.8432000000003 825.9280000000001Q3187.8336 851.224 3131.2896 851.224Z M3318.1824 845.272V541.72H3405.6768V613.144H3407.4624000000003V845.272ZM3529.4784 845.272V657.1888Q3529.4784 632.1904000000001 3516.6816 619.6912Q3503.8848000000003 607.192 3479.4816 607.192Q3458.6496 607.192 3442.2816000000003 616.7152Q3425.9136000000003 626.2384 3416.688 642.904Q3407.4624000000003 659.5696 3407.4624000000003 682.1872000000001L3399.7248 608.9776Q3414.6048 575.6464000000001 3443.472 555.7072000000001Q3472.3392000000003 535.768 3514.5984000000003 535.768Q3565.1904000000004 535.768 3591.9744 564.04Q3618.7584 592.312 3618.7584 639.928V845.272Z M3889.5744000000004 845.272V778.0144L3895.5264 779.2048Q3889.5744000000004 811.9408000000001 3860.112 831.5824Q3830.6496 851.224 3789.5808 851.224Q3747.9168000000004 851.224 3717.264 831.8800000000001Q3686.6112000000003 812.5360000000001 3669.9456 777.4192Q3653.28 742.3024 3653.28 694.6864Q3653.28 646.4752000000001 3670.5408 610.7632000000001Q3687.8016000000002 575.0512 3719.0496000000003 555.4096Q3750.2976000000003 535.768 3791.9616000000005 535.768Q3835.4112000000005 535.768 3862.4928000000004 556.0048Q3889.5744000000004 576.2416000000001 3894.3360000000002 611.3584000000001L3887.7888000000003 611.9536V416.728H3977.0688000000005V845.272ZM3818.1504000000004 779.8000000000001Q3849.6960000000004 779.8000000000001 3869.3376000000003 757.48Q3888.9792 735.1600000000001 3888.9792 693.4960000000001Q3888.9792 651.832 3869.04 629.512Q3849.1008 607.192 3816.9600000000005 607.192Q3786.0096000000003 607.192 3766.0704000000005 629.8096Q3746.1312000000003 652.4272000000001 3746.1312000000003 694.0912000000001Q3746.1312000000003 735.7552000000001 3766.0704000000005 757.7776000000001Q3786.0096000000003 779.8000000000001 3818.1504000000004 779.8000000000001Z%22/%3E%3C/svg%3E)
 scale(0.100000,-0.100000)%22%3E%3Cpath d=%22M4297 11020 c-251 -23 -537 -106 -727 -212 -443 -246 -736 -645 -826 -1123 -18 -97 -19 -207 -19 -3245 0 -3437 -4 -3204 61 -3464 145 -585 533 -1052 1103 -1330 52 -25 105 -46 118 -46 39 0 90 26 110 56 17 27 18 80 24 959 5 900 6 934 28 1060 53 314 144 569 297 832 219 376 589 741 999 983 50 29 119 70 155 91 177 104 553 265 830 353 495 159 1130 272 1651 293 l156 6 -3 -229 c-7 -645 -130 -1193 -376 -1677 -155 -306 -373 -585 -598 -766 -329 -265 -571 -377 -1169 -542 -500 -137 -709 -225 -974 -409 -116 -80 -331 -295 -415 -415 -113 -160 -204 -370 -238 -552 -15 -79 -14 -89 1 -129 10 -28 28 -51 49 -64 33 -20 41 -20 1478 -20 1442 0 1599 3 1808 36 677 106 1325 449 1770 938 130 141 202 234 296 376 549 834 695 1868 404 2865 -103 350 -280 710 -483 980 -361 479 -868 808 -1442 935 -328 73 -460 80 -1577 80 l-908 0 0 1108 c0 1199 0 1198 -55 1387 -76 262 -240 486 -464 636 -134 90 -197 122 -340 169 -216 72 -482 102 -724 80z%22/%3E%3Cpath d=%22M6314 10340 c-26 -10 -72 -65 -79 -93 -3 -12 -4 -400 -3 -862 l3 -840 28 -79 c78 -222 264 -396 497 -467 l75 -23 867 -4 c958 -3 918 -6 958 60 11 18 20 45 20 60 0 60 79 -22 -1100 1143 -927 916 -1090 1075 -1122 1095 -34 21 -105 26 -144 10z%22/%3E%3C/g%3E%3C/g%3E%3Cpath fill=%22%23FFFFFF%22 d=%22M1436.7552 845.272V779.8000000000001H1547.4624000000001Q1577.2224 779.8000000000001 1592.4 763.432Q1607.5776 747.0640000000001 1607.5776 717.8992000000001Q1607.5776 688.1392000000001 1591.2096000000001 670.8784Q1574.8416 653.6176 1544.4864 653.6176H1436.7552V588.1456000000001H1539.7248Q1567.6992 588.1456000000001 1582.2816 574.7536Q1596.864 561.3616 1596.864 535.1728Q1596.864 508.98400000000004 1582.8768 495.592Q1568.8896 482.2 1541.5104000000001 482.2H1436.7552V416.728H1561.152Q1618.2912000000001 416.728 1653.4080000000001 445.8928Q1688.5248000000001 475.05760000000004 1688.5248000000001 525.0544Q1688.5248000000001 556.6 1673.6448 579.2176Q1658.7648 601.8352 1633.7664 613.7392Q1608.768 625.6432 1577.8176 625.6432L1580.7936 613.144Q1614.1248 613.144 1641.2064 627.4288Q1668.288 641.7136 1684.3584 667.6048000000001Q1700.4288000000001 693.4960000000001 1700.4288000000001 728.6128Q1700.4288000000001 763.7296 1684.0608000000002 790.216Q1667.6928 816.7024 1638.2304 830.9872Q1608.768 845.272 1568.8896 845.272ZM1361.76 845.272V416.728H1453.4208V845.272Z M1742.0928 845.272V416.728H1831.3727999999999V845.272Z M2034.9312 851.224Q1984.9343999999999 851.224 1947.1391999999998 831.2848000000001Q1909.3439999999998 811.3456000000001 1888.2143999999998 775.336Q1867.0847999999999 739.3264 1867.0847999999999 692.3056Q1867.0847999999999 645.2848 1888.2143999999998 610.168Q1909.3439999999998 575.0512 1947.1391999999998 555.4096Q1984.9343999999999 535.768 2034.9312 535.768Q2085.5232 535.768 2123.3184 555.4096Q2161.1135999999997 575.0512 2181.9456 610.168Q2202.7776 645.2848 2202.7776 692.3056Q2202.7776 739.3264 2181.648 775.336Q2160.5184 811.3456000000001 2122.7232 831.2848000000001Q2084.928 851.224 2034.9312 851.224ZM2034.9312 780.9904Q2055.7632 780.9904 2072.7263999999996 770.2768000000001Q2089.6895999999997 759.5632 2099.808 739.624Q2109.9264 719.6848 2109.9264 691.7104Q2109.9264 650.6416 2088.2016 628.3216Q2066.4768 606.0016 2034.9312 606.0016Q2003.3855999999998 606.0016 1981.6607999999999 628.6192000000001Q1959.936 651.2368 1959.936 691.7104Q1959.936 719.6848 1970.0544 739.624Q1980.1727999999998 759.5632 1997.136 770.2768000000001Q2014.0991999999999 780.9904 2034.9312 780.9904Z M2378.3615999999997 973.24Q2315.2704 973.24 2275.6895999999997 946.456Q2236.1088 919.672 2228.9664 873.8416000000001H2313.4847999999997Q2318.2464 885.1504000000001 2334.0191999999997 891.1024000000001Q2349.792 897.0544000000001 2374.1952 897.0544000000001Q2414.6688 897.0544000000001 2433.12 881.5792000000001Q2451.5712 866.104 2451.5712 833.368V767.3008L2456.3328 768.4912Q2450.3808 801.8224 2421.8112 821.1664000000001Q2393.2416 840.5104 2350.9824 840.5104Q2310.5088 840.5104 2280.4512 821.7616Q2250.3936 803.0128000000001 2233.728 769.0864000000001Q2217.0624 735.1600000000001 2217.0624 689.3296Q2217.0624 642.904 2234.3232 608.3824Q2251.584 573.8608 2282.832 554.8144Q2314.08 535.768 2355.7439999999997 535.768Q2398.5984 535.768 2425.68 556.0048Q2452.7616 576.2416000000001 2457.5232 611.3584000000001L2453.3568 611.9536V541.72H2540.8512V832.1776000000001Q2540.8512 897.6496000000001 2497.4016 935.4448Q2453.9519999999998 973.24 2378.3615999999997 973.24ZM2381.9328 772.0624Q2413.4784 772.0624 2433.12 750.3376000000001Q2452.7616 728.6128 2452.7616 688.1392000000001Q2452.7616 647.6656 2432.8224 625.9408000000001Q2412.8831999999998 604.216 2380.7424 604.216Q2349.792 604.216 2329.8527999999997 626.2384Q2309.9136 648.2608 2309.9136 688.7344Q2309.9136 729.2080000000001 2329.8527999999997 750.6352Q2349.792 772.0624 2381.9328 772.0624Z%22/%3E%3Cpath fill=%22%235B93FF%22 d=%22M2718.8160000000003 845.272V486.96160000000003H2578.944V416.728H2950.3488V486.96160000000003H2810.4768V845.272Z M3131.2896 851.224Q3080.6976 851.224 3043.2 831.2848000000001Q3005.7024 811.3456000000001 2985.168 775.6336000000001Q2964.6336 739.9216 2964.6336 693.4960000000001Q2964.6336 646.4752000000001 2985.168 611.0608000000001Q3005.7024 575.6464000000001 3042.6048 555.7072000000001Q3079.5072 535.768 3128.3136 535.768Q3175.3344 535.768 3209.856 554.8144Q3244.3776000000003 573.8608 3263.424 607.7872Q3282.4704 641.7136 3282.4704 687.5440000000001Q3282.4704 697.0672000000001 3281.8752000000004 705.1024Q3281.28 713.1376 3280.0896000000002 720.28H3017.0112V661.3552H3208.0704L3192.5952 672.0688Q3192.5952 635.1664000000001 3175.0368 617.6080000000001Q3157.4784 600.0496 3127.1232 600.0496Q3092.0064 600.0496 3072.6624 623.8576Q3053.3184 647.6656 3053.3184 695.2816Q3053.3184 741.7072000000001 3072.6624 764.3248000000001Q3092.0064 786.9424 3130.6944000000003 786.9424Q3152.1216 786.9424 3167.5968000000003 779.8Q3183.072 772.6576 3190.8096 756.5872H3274.7328Q3259.8528 800.6320000000001 3223.8432000000003 825.9280000000001Q3187.8336 851.224 3131.2896 851.224Z M3318.1824 845.272V541.72H3405.6768V613.144H3407.4624000000003V845.272ZM3529.4784 845.272V657.1888Q3529.4784 632.1904000000001 3516.6816 619.6912Q3503.8848000000003 607.192 3479.4816 607.192Q3458.6496 607.192 3442.2816000000003 616.7152Q3425.9136000000003 626.2384 3416.688 642.904Q3407.4624000000003 659.5696 3407.4624000000003 682.1872000000001L3399.7248 608.9776Q3414.6048 575.6464000000001 3443.472 555.7072000000001Q3472.3392000000003 535.768 3514.5984000000003 535.768Q3565.1904000000004 535.768 3591.9744 564.04Q3618.7584 592.312 3618.7584 639.928V845.272Z M3889.5744000000004 845.272V778.0144L3895.5264 779.2048Q3889.5744000000004 811.9408000000001 3860.112 831.5824Q3830.6496 851.224 3789.5808 851.224Q3747.9168000000004 851.224 3717.264 831.8800000000001Q3686.6112000000003 812.5360000000001 3669.9456 777.4192Q3653.28 742.3024 3653.28 694.6864Q3653.28 646.4752000000001 3670.5408 610.7632000000001Q3687.8016000000002 575.0512 3719.0496000000003 555.4096Q3750.2976000000003 535.768 3791.9616000000005 535.768Q3835.4112000000005 535.768 3862.4928000000004 556.0048Q3889.5744000000004 576.2416000000001 3894.3360000000002 611.3584000000001L3887.7888000000003 611.9536V416.728H3977.0688000000005V845.272ZM3818.1504000000004 779.8000000000001Q3849.6960000000004 779.8000000000001 3869.3376000000003 757.48Q3888.9792 735.1600000000001 3888.9792 693.4960000000001Q3888.9792 651.832 3869.04 629.512Q3849.1008 607.192 3816.9600000000005 607.192Q3786.0096000000003 607.192 3766.0704000000005 629.8096Q3746.1312000000003 652.4272000000001 3746.1312000000003 694.0912000000001Q3746.1312000000003 735.7552000000001 3766.0704000000005 757.7776000000001Q3786.0096000000003 779.8000000000001 3818.1504000000004 779.8000000000001Z%22/%3E%3C/svg%3E)
Cómo la investigación web en tiempo real garantiza la precisión del contenido en el blogging automatizado
Los sistemas de blogging automatizado que utilizan investigación web en tiempo real reducen las tasas de alucinación entre un 73% y un 86% mediante la recuperación de datos en tiempo real. Este artículo explica cómo funciona la generación aumentada por recuperación (RAG) y por qué es importante para el SEO.
Los sistemas de blogging automatizados que dependen exclusivamente de modelos de lenguaje grandes preentrenados suelen generar errores factuales y afirmaciones obsoletas. La investigación web en vivo para el blogging automatizado, basada en arquitecturas de generación aumentada por recuperación (RAG), reduce las tasas de alucinación entre un 73% y un 86% al integrar datos en tiempo real en el proceso de generación, en lugar de depender de pesos de entrenamiento estáticos.
Por qué el contenido automatizado estándar falla en los hechos
Los modelos de lenguaje grandes generan texto prediciendo los siguientes tokens probables basándose en patrones de entrenamiento. Esto crea una prosa fluida, pero no garantiza la precisión. Cuando un modelo carece de conocimiento paramétrico fiable para una afirmación específica, alucina. Fabrica hechos, citas, fechas o estadísticas que suenan plausibles pero son falsos.
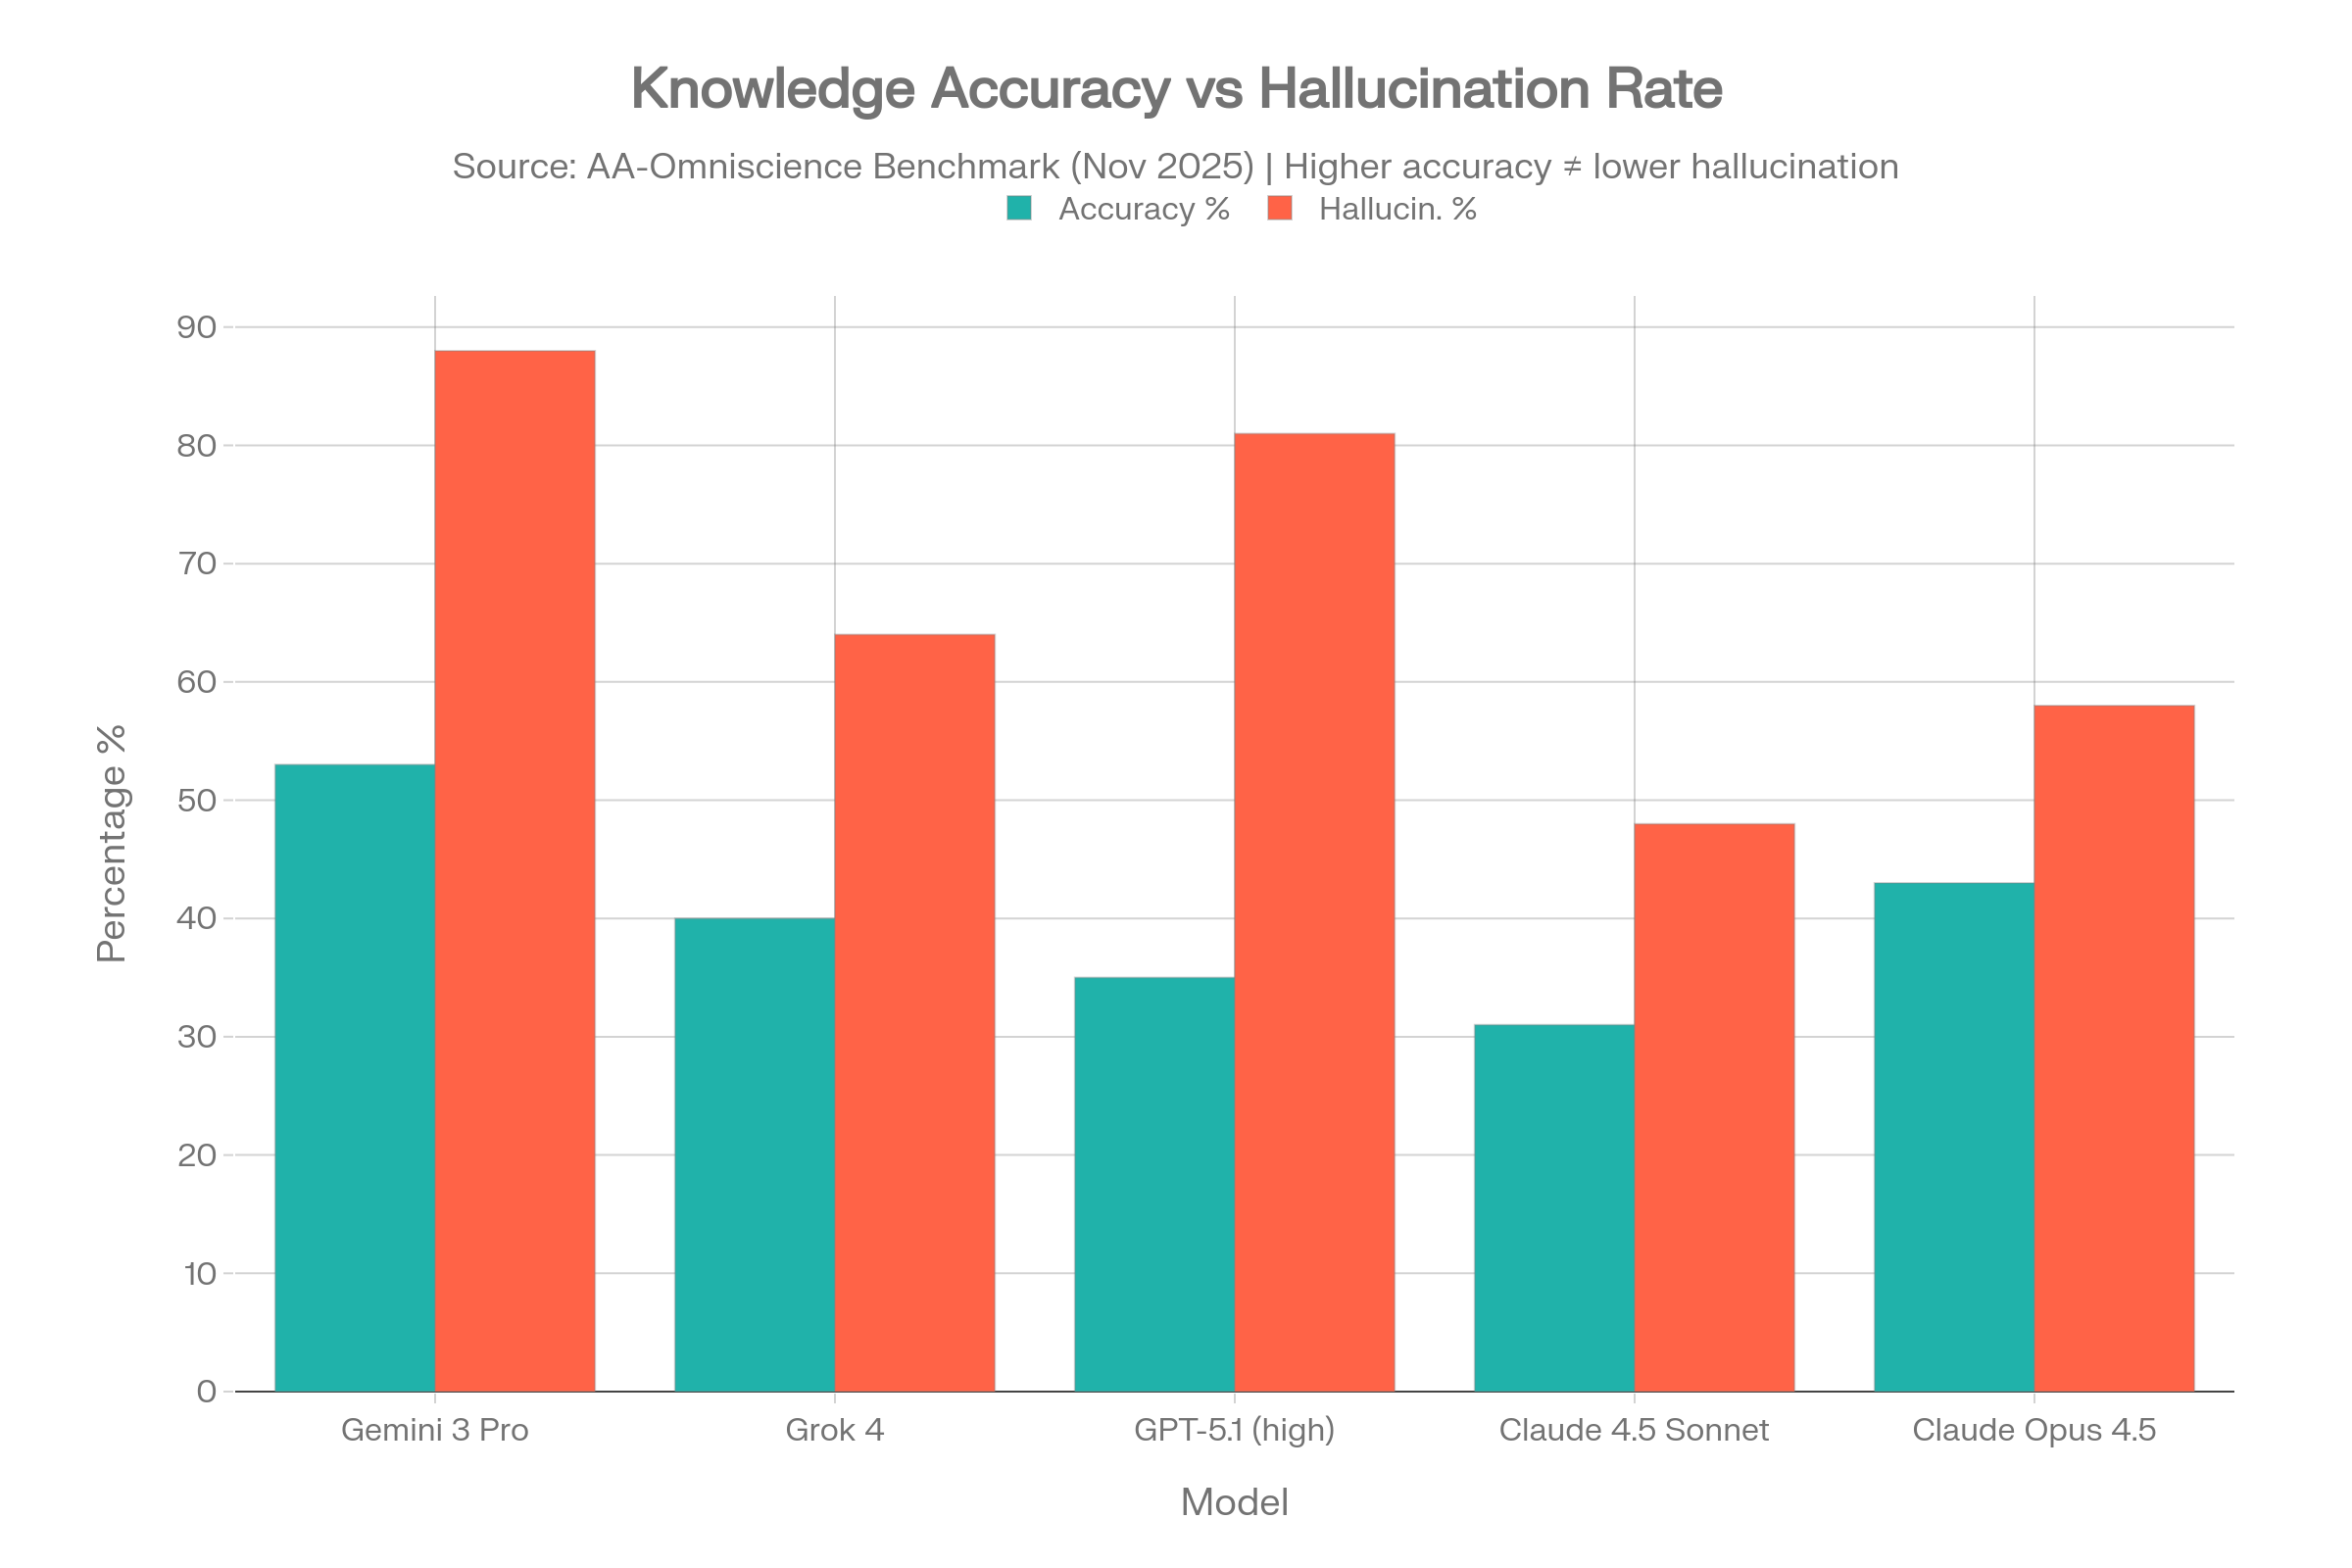
En benchmarks de dominio abierto como FActScore y SimpleQA, los LLMs sin anclaje alucinan a tasas entre el 37% y el 47% en tareas de formato largo, según el análisis de precisión de Suprmind de 2026. El problema empeora en nichos de rápida evolución donde los datos de entrenamiento no pueden captar los desarrollos recientes.
Los modelos estáticos fallan rutinariamente en:
- Precios actuales, tipos de cambio y datos de mercado
- Regulaciones recién promulgadas o cambios de política
- Noticias de última hora y tendencias emergentes
- Especificaciones y disponibilidad de productos
- Estadísticas actualizadas de investigaciones en curso
Sin recuperación de datos en vivo, una publicación de blog automatizada sobre "umbrales de declaración de impuestos de 2026" probablemente propagará información obsoleta. Los lectores lo notan, la confianza se erosiona y los motores de búsqueda penalizan el contenido pobre.
Qué significa la investigación web en vivo para el blogging automatizado
La investigación web en vivo en la automatización es la práctica de consultar motores de búsqueda, APIs y bases de datos estructuradas durante la generación de contenido. El sistema luego inyecta la información recuperada en la ventana de contexto del modelo. Esto depende de la recuperación en tiempo real en lugar de procesar previamente una base de conocimientos estática.
Esta técnica se llama Generación Aumentada por Recuperación (RAG). Formalizada por primera vez en la investigación de Lewis et al. de 2020 sobre tareas de PLN intensivas en conocimiento, RAG separa la capacidad de razonamiento del modelo de lenguaje de su base de conocimientos fácticos. El modelo escribe; el sistema de recuperación proporciona los hechos.
Las stacks modernas de blogging automatizado utilizan dos capas de recuperación distintas:
| Tipo de capa | Ejemplos | Formato de salida | Mejor adecuado para |
|---|---|---|---|
| Recuperación web nativa de IA | Tavily, Exa, Linkup, Brave Search API | Markdown pre-limpio, resúmenes semánticos | Inyección directa en el contexto del LLM |
| Scrapers de SERP tradicionales | SerpApi, Serper.dev, Firecrawl | Metadatos brutos de SERP, requiere análisis HTML | Pipelines de extracción personalizados |
Microsoft retiró la API de búsqueda Bing independiente el 11 de agosto de 2025, acelerando la migración hacia alternativas nativas de IA. La API de Brave Search indexa más de 40 mil millones de páginas independientemente de Google o Bing, ofreciendo un corpus distinto para la verificación.
El pipeline de investigación en vivo: De la consulta al hecho publicado
Un pipeline RAG de producción para el blogging automatizado sigue cinco etapas secuenciales. Cada etapa añade latencia pero mejora la calidad de la salida.
- Formulación de la consultaEl sistema analiza el brief del artículo y convierte las afirmaciones en consultas de búsqueda específicas. "Discutir las tasas de impuestos sobre ganancias de capital de 2026" se transforma en consultas dirigidas a publicaciones del IRS y periodismo financiero verificado.
- Recuperación de fuentesLas APIs de búsqueda devuelven resultados clasificados. Los pipelines avanzados ejecutan múltiples consultas paralelas y aplican re-ranking mediante cross-encoders para destacar los pasajes más relevantes.
- Inyección de contextoEl texto recuperado se divide en fragmentos, se deduplica y se formatea para la ventana de contexto del LLM. Las APIs nativas de IA como Tavily devuelven markdown preestructurado optimizado para este paso.
- Generación con anclajeEl modelo genera prosa restringida por el contexto inyectado. Puede citar, parafrasear o sintetizar, pero sus afirmaciones fácticas están vinculadas a las fuentes recuperadas en lugar de a la memoria paramétrica.
- Generación con anclajeEl modelo genera prosa restringida por el contexto inyectado. Puede citar, parafrasear o sintetizar, pero sus afirmaciones fácticas están vinculadas a las fuentes recuperadas en lugar de a la memoria paramétrica.
This latency is prohibitive for interactive chatbots but manageable for automated blogging. Production pipelines decouple generation from user requests using asynchronous job queues such as Celery or BullMQ. Articles generate in the background and publish on schedule.
Source Attribution and Trust Signals
El contenido con investigación en vivo incluye citas en línea a fuentes primarias. Esto permite a los lectores verificar las afirmaciones y señala a los motores de búsqueda que el contenido está fundamentado.
La autoridad del dominio es importante en la selección de fuentes. Un flujo de trabajo que recupera datos de dominios .gov, organizaciones de noticias establecidas y revistas revisadas por pares produce resultados más confiables que uno que extrae información de foros sin moderar. Los sistemas de producción filtran por reputación del dominio y excluyen fuentes conocidas de baja credibilidad.
La diferencia entre la salida estática y la salida con investigación en vivo es notable:
| Dimensión | Salida LLM estática | Salida RAG con investigación en vivo |
|---|---|---|
| Actualidad factual | Congelada en el corte de entrenamiento | Actual al momento de la generación |
| Tasa de alucinación (FActScore) | 37–47% | Menor del 10% |
| Verificabilidad de la fuente | Ninguna | Citas en línea a páginas recuperadas |
| Perfil de riesgo SEO | Alto: no original, potencialmente falso | Bajo: fundamentado, fresco |
| Señales de confianza para el lector | Afirmaciones genéricas y sin anclaje | Hechos específicos y atribuidos |
Rendimiento SEO y la postura de Google sobre el contenido automatizado
Google no prohíbe el contenido generado por IA. Prohíbe el contenido de baja calidad y manipulativo, independientemente del método de producción. La guía oficial de Google establece: "Recompensar el contenido de calidad, sin importar cómo se produzca, ha sido fundamental para Search durante muchos años".
Sin embargo, la actualización principal de marzo de 2024 elevó las apuestas. La empresa retiró su clasificador independiente de Contenido Útil e integró las señales de utilidad en los algoritmos principales de clasificación. Introdujo la política de spam de "Abuso de contenido escalado", definida como la generación de muchas páginas principalmente para manipular las clasificaciones de búsqueda sin añadir valor para los usuarios.
El abuso de contenido escalado ocurre cuando se generan muchas páginas con el propósito principal de manipular las clasificaciones de búsqueda y no ayudar a los usuarios. Esta práctica abusiva suele centrarse en crear grandes cantidades de contenido no original que ofrece poco o ningún valor a los usuarios, independientemente de cómo se cree.
Documentación de Google Search Central, Políticas oficiales de spam en la Búsqueda Web
La actualización de marzo de 2024 arrojó resultados medibles: Google confirmó una reducción del 45% en la aparición de contenido de baja calidad y no original en los resultados de búsqueda tras completar la implementación.
La investigación web en vivo aborda directamente las señales de calidad de Google. El contenido fresco y atribuido demuestra Experiencia, Experticia, Autoridad y Confiabilidad (E-E-A-T). Las respuestas precisas reducen las tasas de rebote porque los lectores encuentran lo que buscaban en lugar de toparse con información obsoleta.
Trampas de implementación y cómo manejarlas
La investigación en vivo no equivale automáticamente a calidad. Una mala implementación introduce nuevos modos de fallo.
Contenido de pago y restringido
Los sistemas de recuperación se encuentran frecuentemente con artículos de noticias de pago o documentos de investigación protegidos. Puede recuperarse el titular, pero el contexto factual completo resulta inaccesible. Los flujos de trabajo de producción deben detectar indicadores de muros de pago y excluir estas fuentes o marcarlas para revisión humana, en lugar de sintetizar información incompleta.
Fuentes contradictorias
La búsqueda en vivo puede devolver afirmaciones contradictorias de fuentes igualmente creíbles. Los flujos de trabajo robustos exponen estos conflictos en lugar de seleccionar arbitrariamente una versión. El artículo generado debe reconocer la incertidumbre o presentar múltiples perspectivas verificadas.
Contaminación por scrapers de baja calidad
Los resultados de búsqueda incluyen granjas de contenido y resúmenes autogenerados que carecen de reportajes originales. Sin filtrado, un flujo de trabajo RAG puede ingerir y regurgitar este material. Las listas blancas de dominios, la ponderación de frescura del contenido y la deduplicación semántica ayudan a excluir el ruido.
Límites de derechos de autor y uso justo
El scraping en vivo plantea consideraciones legales. Los sistemas de recuperación descargan y almacenan temporalmente contenido web protegido por derechos de autor para su análisis. El uso justo generalmente protege la copia intermedia para fines transformativos como el resumen, pero la reproducción total infringe los derechos de autor. Los flujos de trabajo automatizados de blogs deben:
- Limitar las citas directas a extractos breves y atribuidos
- Transformar la información recuperada mediante síntesis y estructura originales
- Enlazar a las fuentes en lugar de sustituir por ellas
- Respetar el robots.txt y los términos de servicio de los sitios objetivo
El valor añadido de la investigación en vivo es la verificación y la actualidad. Los sistemas que simplemente republican texto extraído sin transformación violan tanto las políticas de spam de Google como la ley de derechos de autor.
Evaluar si tu configuración necesita investigación en vivo
No todas las entradas de blog requieren recuperación en tiempo real. El contenido evergreen (de referencia) sobre temas establecidos puede estar bien servido por bases de conocimiento estáticas bien curadas. Sin embargo, la investigación en vivo se vuelve esencial cuando el contenido cubre:
- Noticias sensibles al tiempo y análisis de tendencias
- Datos financieros, precios y condiciones del mercado
- Cumplimiento normativo y requisitos legales
- Reseñas y especificaciones de productos
- Inteligencia competitiva y puntos de referencia del sector
- Cobertura de eventos y anuncios programados
Si tu blog automatizado opera en estos dominios y actualmente genera contenido sin anclaje en vivo, tu tasa de errores factuales probablemente se acerca al 37–47% de línea base documentado en investigación sobre alucinaciones de LLM. La mejora del 73% al 86% gracias a la integración de RAG representa una actualización directa de calidad que lectores y motores de búsqueda detectarán.
Qué comprobar antes de publicar tu próxima entrada automatizada
- ¿Cada estadística, fecha y nombre propio proviene de una fuente recuperada con una URL funcional?
- ¿Las fuentes provienen de dominios creíbles en lugar de foros no verificados o granjas de contenido?
- ¿El artículo añade estructura original y síntesis, o meramente reordena frases extraídas?
- ¿Has verificado que no se citen fuentes de pago sin evidencia accesible?
- ¿La información está actualizada al momento de la generación, o podría haberse colado obsolescencia por el corte de datos de entrenamiento?
El blogging automatizado a escala exige más que una generación fluida de texto. Exige una capa de verificación que conecte cada afirmación con la web en vivo. Si estás evaluando plataformas, compara planes que incluyan infraestructura de investigación en vivo frente a aquellos que dependen únicamente de la salida estática del modelo. Para equipos listos para implementarlo, empieza con un sistema que ancle la generación en datos en tiempo real desde el primer artículo.
Sigue leyendo
Más artículos sobre Automatización del blog
- Blog AutomationOct 4, 2026
Web Integration for Blog Automation: How to Choose the Right Tools
Web integration for blog automation connects content generation pipelines to CMS platforms through APIs and middleware, eliminating manual copy-pasting and enabling scalable publishing workflows.
Lee el artículo - Flujos de trabajo de publicaciónOct 4, 2026
Cómo implementar la automatización de contenido con investigación web en tiempo real para pipelines de escritura con IA
Aprende a construir un pipeline de investigación web en tiempo real que conecte APIs de búsqueda en vivo con sistemas de escritura LLM, incluyendo pasos específicos para extracción de datos, fundamentación en fuentes, atribución automática y validación previa a la publicación.
Lee el artículo - WordPressOct 4, 2026
Pipelines automatizados de contenido en WordPress: integración y flujo de trabajo
La creación automatizada de contenido en WordPress utiliza la API REST para publicar artículos optimizados e investigados por IA directamente en tu sitio. Esto transforma al blogger de escritor a estratega editorial, supervisando prompts, hechos y controles de calidad.
Lee el artículo